TL;DR
- 제 웹 앱 프로젝트의
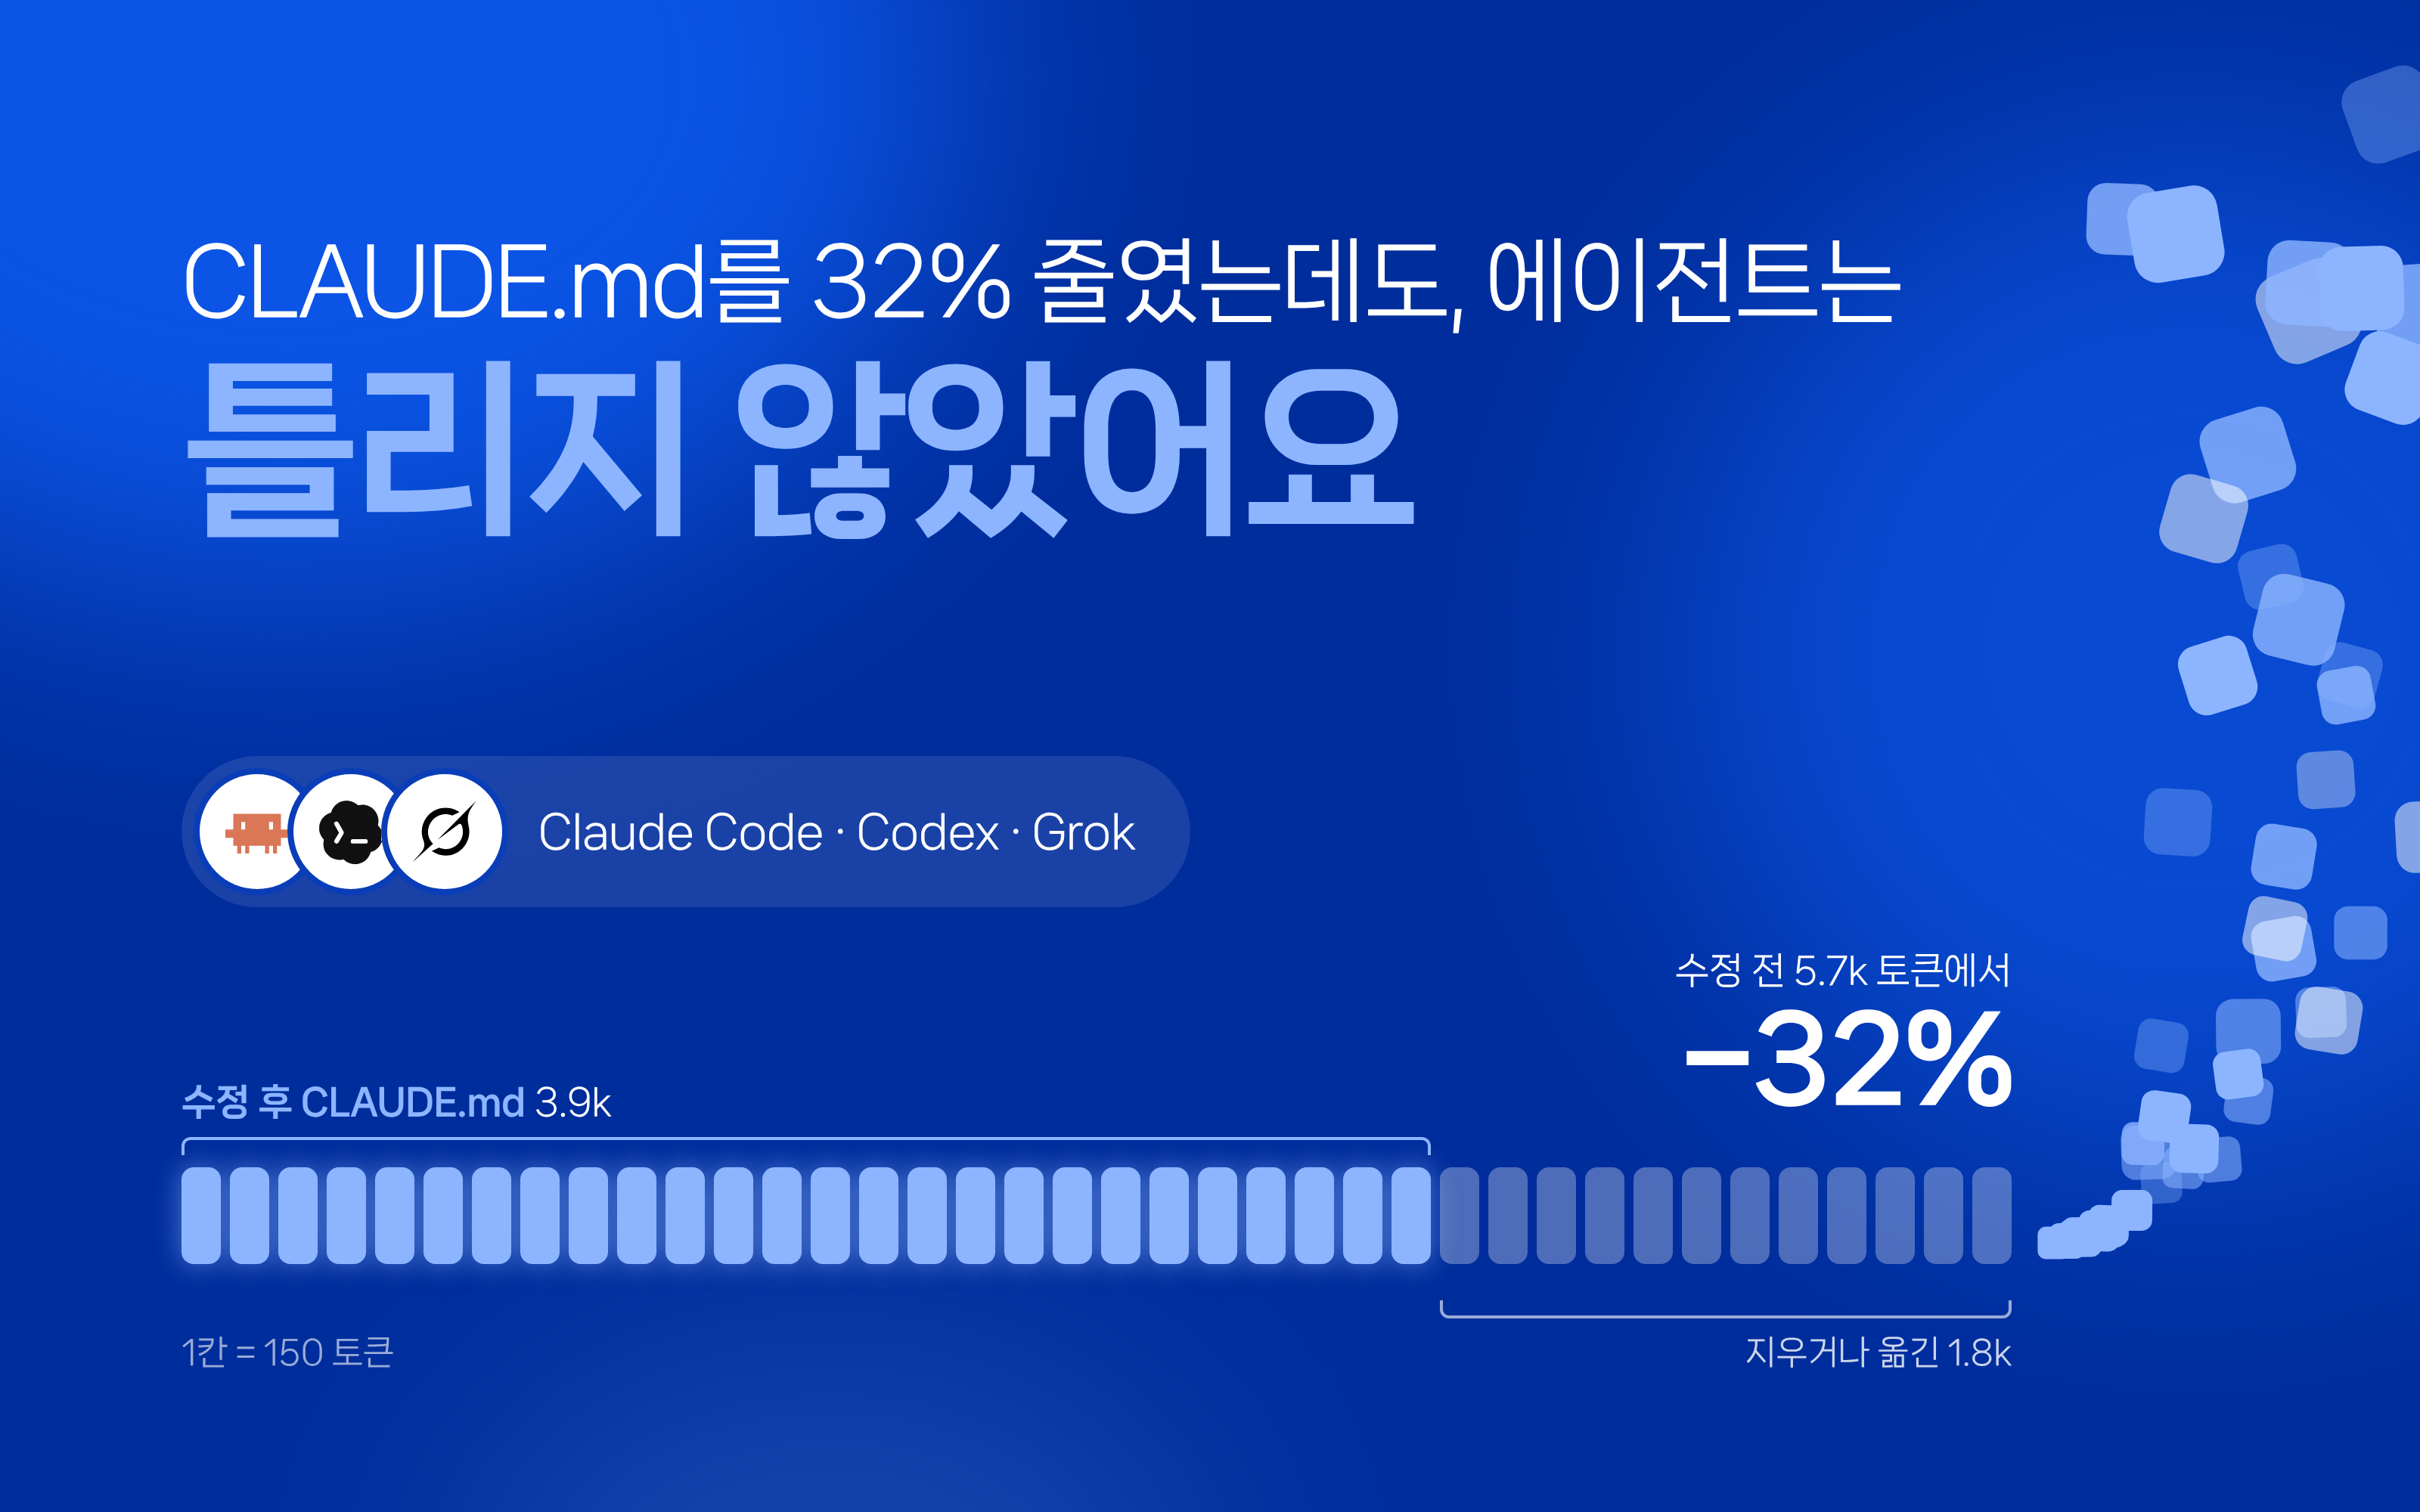
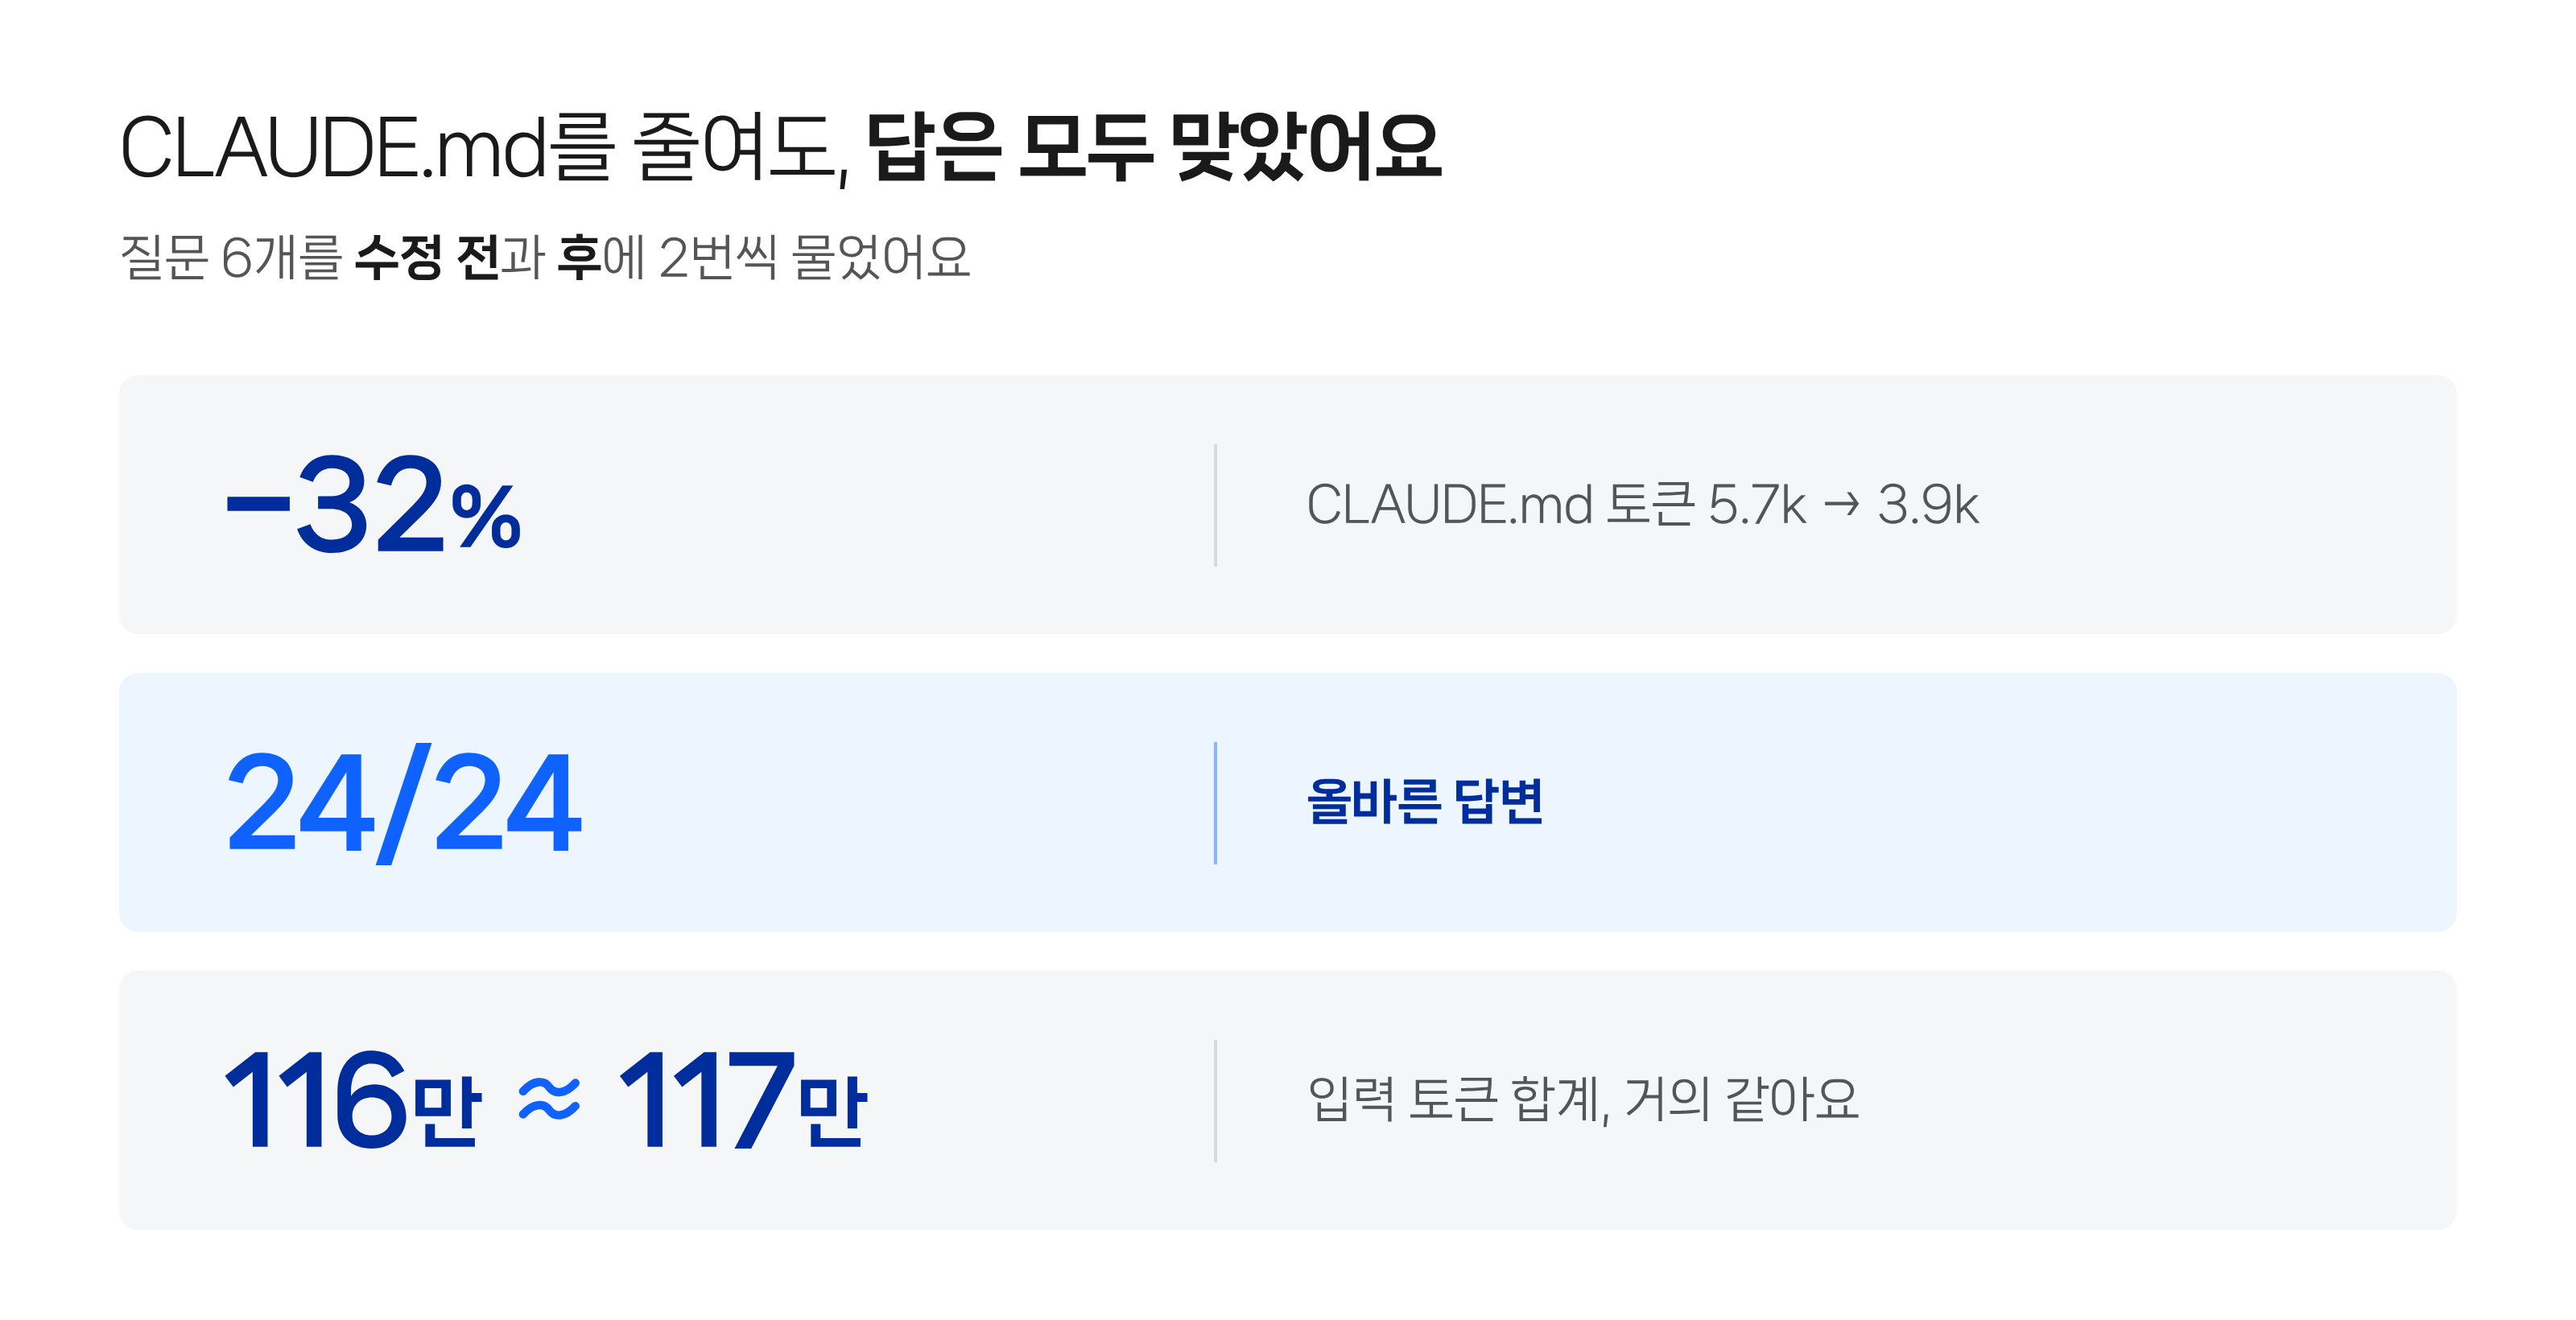
CLAUDE.md를 5.7k 토큰에서 3.9k 토큰으로 32% 줄였어요.CLAUDE.md에서 지우거나 다른 파일로 옮긴 정보를 물었더니, 에이전트는 그 정보를 다른 파일에서 찾아 모두 올바르게 답했어요.CLAUDE.md가 줄어든 만큼, Claude Code는 세션을 시작할 때마다 1.8k 토큰을 덜 실어요. 지운 정보를 다른 파일에서 찾느라 도구 호출이 늘어난 질문도 있었어요. 그래도 지우거나 옮기거나 고친 문장을 일부러 묻는 질문 6개에서, 에이전트가 처리한 입력 토큰은CLAUDE.md수정 전 116만 토큰, 수정 후 117만 토큰으로 거의 같았어요./writing-for-agents와/doctor prompt-audit는 코드와 어긋난 문장을 하나씩 찾았는데, 서로 다른 문장이었어요. 저는 두 도구를 모두 실행하고도 한 도구의 진단만 반영해서, 다른 도구가 찾은 문장을 남겼어요. 두 진단을 한 목록으로 합쳐 고치면 서로 놓친 곳을 메울 수 있어요.- 지침 파일을 줄일 때는 줄마다 no-op, 중복, cache, sediment, 특정 작업에서만 필요한 내용인지 묻고, 지운 뒤에는 같은 질문을 에이전트에게 다시 물어 확인하세요. 코드만 보고는 알 수 없는 안전 규칙과 이유는 남겨 두고요.
저도 CLAUDE.md에 규칙을 더해 왔어요. 저만 그런 건 아니에요. r/ClaudeAI에서 추천 489개를 받은 글은 대화를 돌아보며 CLAUDE.md에 규칙을 계속 더하면 에이전트가 점점 나아진다고 소개해요. (출처: I discovered a powerful way to continuously improve my CLAUDE.md instructions for Claude Code - r/ClaudeAI)
하지만 지침 파일에 쌓인 문장에는 대가가 있어요. 에이전트는 세션을 시작할 때 CLAUDE.md나 AGENTS.md 같은 지침 파일을 context에 넣어요. 그래서 문장이 늘수록 세션마다 싣는 토큰이 늘고, 그만큼 비용도 늘어요. 성능도 떨어질 수 있어요. Claude Code 공식 문서는 CLAUDE.md가 너무 길면 Claude가 정작 따라야 할 지시를 무시하게 된다고 경고해요. (출처: Best practices for Claude Code - Claude Code Docs) 지침 파일이 비용과 성능에 주는 영향은 이전 글에서 자세히 다뤘어요.
그래서 저는 비용을 줄이고 에이전트가 지시를 제대로 따르게 하려고, 제 웹 앱 프로젝트의 CLAUDE.md에서 지워도 되는 문장을 지우고, 코드와 맞지 않는 문장을 고치고, 특정 작업에서만 필요한 내용은 다른 파일로 옮겼어요. 그러자 CLAUDE.md의 토큰 수가 5.7k 토큰에서 3.9k 토큰으로 32% 줄었어요.
그런데 지침 파일을 줄이면, 에이전트가 필요한 정보를 몰라서 틀리게 답하지 않을까요? 이를 확인하려고, 지우거나 옮기거나 고친 문장의 내용을 알아야 답할 수 있는 질문 6개를 만들었어요. 그리고 CLAUDE.md를 수정하기 전과 후에 각각 에이전트에게 질문마다 2번씩, 모두 24번 물었어요. 에이전트는 24번 모두 올바르게 답했어요.
지우거나 옮긴 정보는 다른 파일에서 찾아냈어요. 프로젝트 하나에서 얻은 결과라서, 여러분의 프로젝트에서 같은 비교를 해 보는 순서를 글 끝에 적어 두었어요.
/context로 지침 파일이 세션마다 싣는 토큰 수를 잴 수 있어요
이 웹 앱 프로젝트는 새 웹 서비스를 시작할 때 복제해 쓰는 React Router·Supabase 템플릿이에요. 이 글에서는 예시 프로젝트라고 부를게요. 토큰 수는 /context 명령으로 쟀어요. /context는 Claude Code에서 지금 context에 무엇이 몇 토큰씩 실려 있는지 항목별로 보여 주는 명령이에요. 예시 프로젝트에서 CLAUDE.md를 수정하기 전 커밋과 수정한 뒤 커밋을 git worktree로 각각 다른 폴더에서 체크아웃하고, 두 폴더에서 새 Claude Code 세션을 열어 /context를 실행했어요. 지침 파일은 /context 결과의 Memory files 항목에 나와요.
# 수정 전
Memory files · /memory
├ ~/.claude/CLAUDE.md: 4k tokens
└ CLAUDE.md: 5.7k tokens

# 수정 후
Memory files · /memory
├ ~/.claude/CLAUDE.md: 4k tokens
└ CLAUDE.md: 3.9k tokens
예시 프로젝트 CLAUDE.md의 토큰 수는 5.7k 토큰에서 3.9k 토큰으로 1.8k 토큰 줄었어요. 줄 수는 106줄에서 85줄이 됐어요. 사용자 전역 지침(~/.claude/CLAUDE.md)은 손대지 않아서 4k 토큰 그대로예요. 그래서 둘을 합친 Memory files 값은 9.7k 토큰에서 7.9k 토큰이 됐어요.
/writing-for-agents와 /doctor prompt-audit를 함께 실행하면 서로 놓친 문장을 찾을 수 있어요
지울 문장은 도구로 찾았어요. Matt Pocock이 만든 writing-for-agents skill은 CLAUDE.md, AGENTS.md를 만들거나 고칠 때 쓰는 skill이에요. 예시 프로젝트의 CLAUDE.md에 /writing-for-agents를 실행하자, 이 skill은 고칠 곳 9곳을 짚었어요. 저는 그 결과를 바탕으로 CLAUDE.md의 문장을 지우고, 옮기고, 고쳤어요. 수정하기 전에는 Claude Code에 들어 있는 점검 명령 /doctor prompt-audit도 같은 파일에 따로 실행해서, 두 도구가 짚은 곳을 비교했어요.
그런데 CLAUDE.md의 내용이 실제 코드와 맞지 않는 곳은, 두 도구가 서로 다르게 짚었어요.
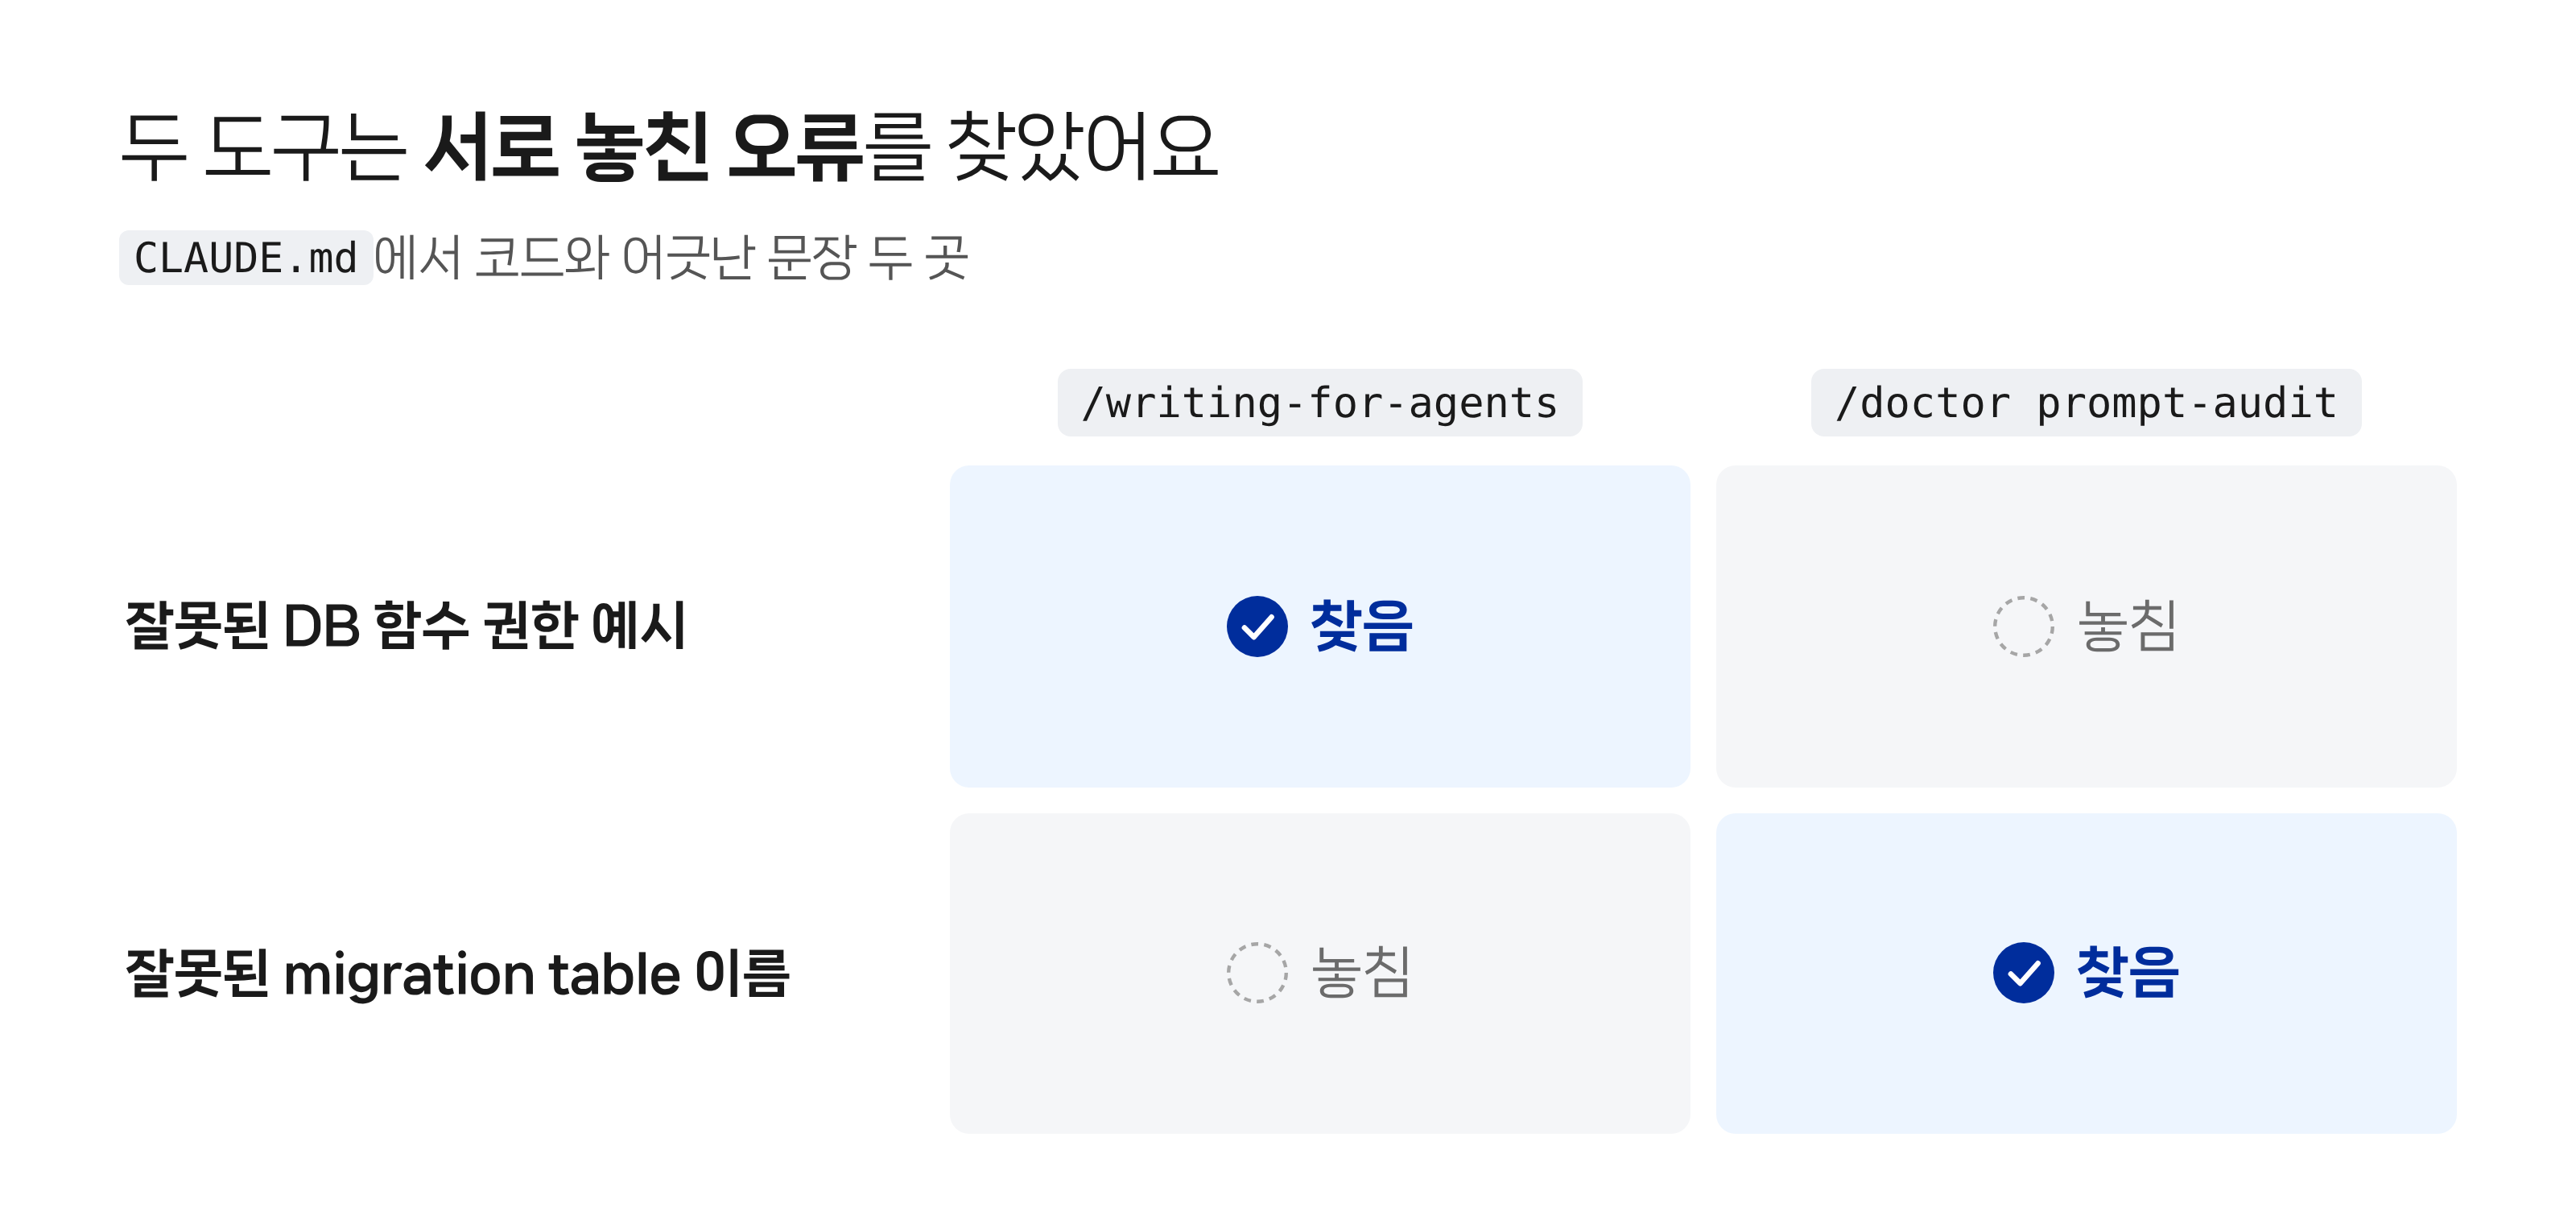
/writing-for-agents는 권한 규칙의 예로 든 DB 함수에 관한 내용에 문제가 있다고 짚었어요. CLAUDE.md는 그 함수를 "로그인한 사용자에게만 실행을 허용한 함수"의 예로 들었는데, 실제 코드에서는 로그인하지 않은 방문자도 그 함수를 실행할 수 있었어요. /doctor prompt-audit는 이 내용을 짚지 않았어요.
반대로 /doctor prompt-audit는 migration 적용 기록 table의 이름이 잘못 적힌 문장을 짚었어요. 그 문장에는 같은 DB를 쓰는 다른 서비스의 table 이름이 적혀 있었어요. /writing-for-agents는 이 문장을 짚지 않았어요.
두 문장처럼 지금 코드와 어긋난 옛 정보를 writing-for-agents는 sediment(퇴적물)라고 불러요. 문장을 더하는 일은 안전해 보이고 지우는 일은 위험해 보여서, 지우지 않은 문장이 층층이 쌓인다는 뜻이에요. 두 도구가 찾은 sediment가 서로 달랐으니, 도구 하나의 진단만 따르면 다른 도구만 찾은 sediment는 남을 수 있어요. 저는 두 도구를 모두 실행하고도 /writing-for-agents의 진단만 보고 고쳐서, /doctor prompt-audit만 짚은 table 이름 오류를 수정 후에도 남겼어요. table 이름 문장은 나중에 따로 고쳤어요. 두 도구를 실행하는 데서 그치지 말고, 두 진단을 한 목록으로 합친 뒤 고쳐야 서로 놓친 곳을 메울 수 있어요.
no-op은 지워도 에이전트의 동작이 바뀌지 않는 문장이에요
CLAUDE.md에서 지우거나 한 줄로 줄이거나 옮긴 정보는 모두 다른 파일에 있었어요.
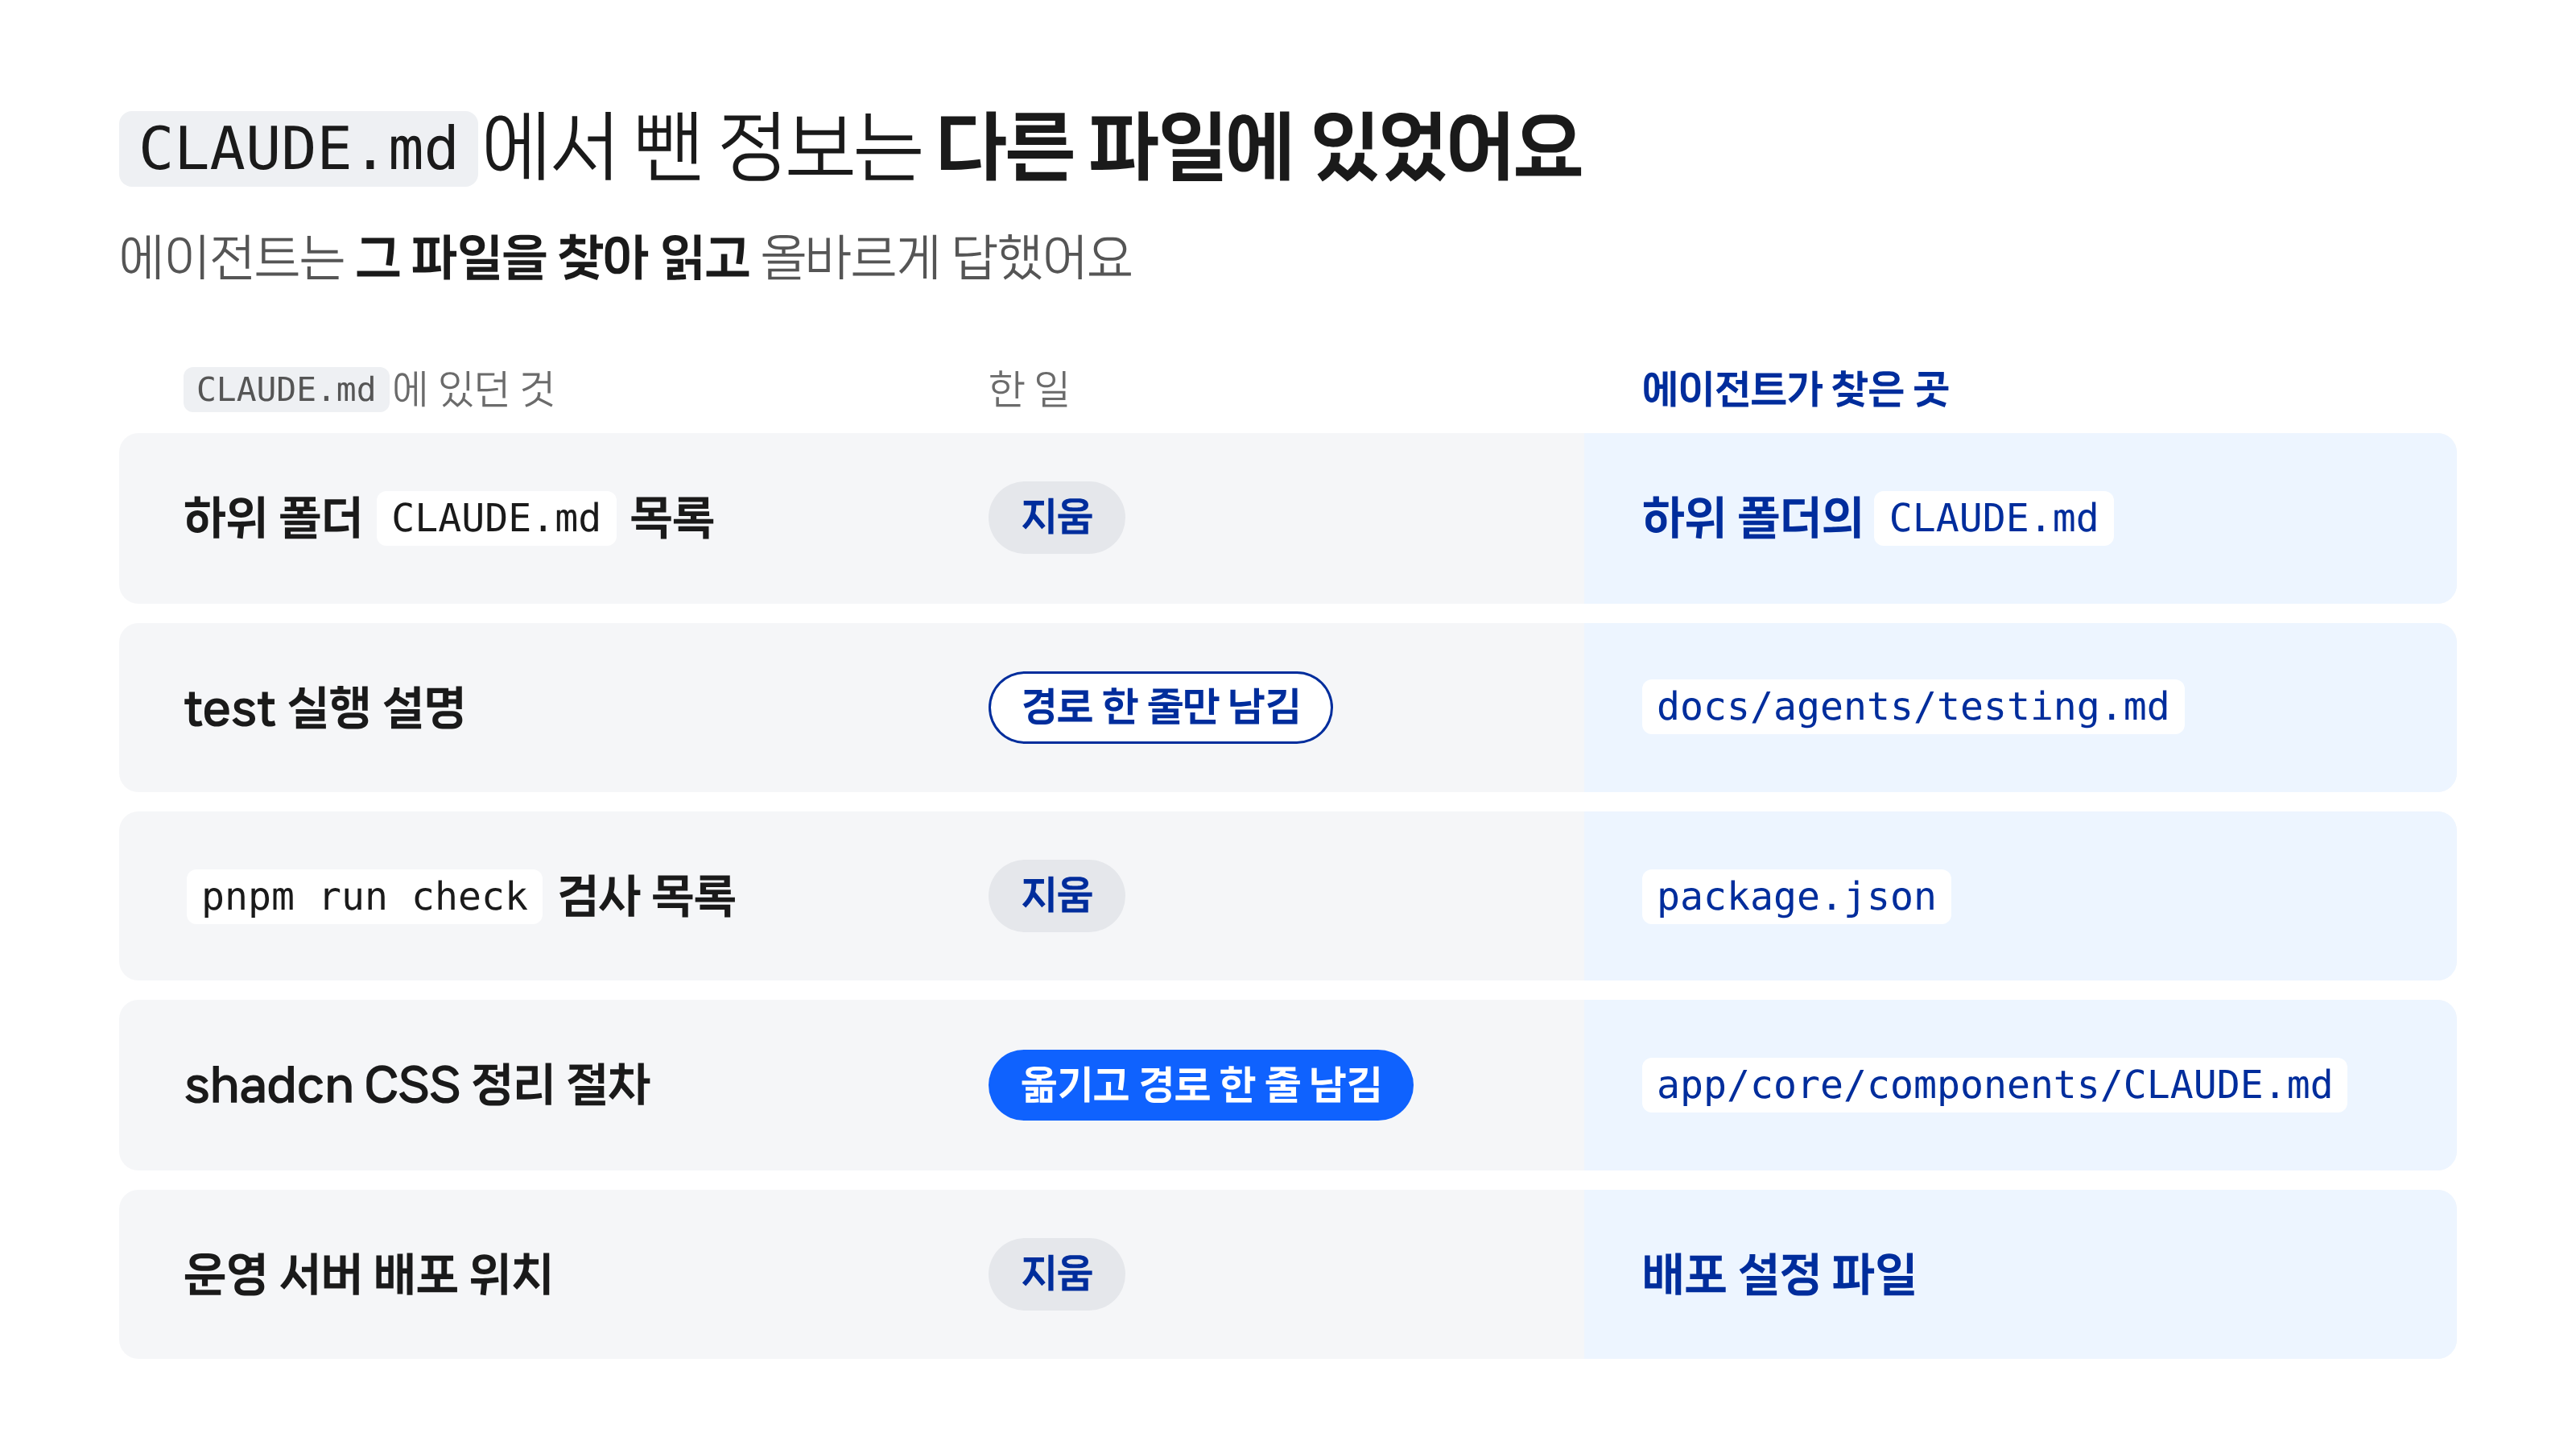
CLAUDE.md 파일을 수정하면서 지운 문장은 세 종류였어요. 첫째는 no-op이에요. 지침이 없어도 에이전트가 알아서 하는 일을 굳이 시키는 문장이라서, 지워도 에이전트의 동작이 바뀌지 않아요. 예시 프로젝트의 최상위 폴더에 있는 CLAUDE.md에는 하위 폴더 4곳에 있는 CLAUDE.md의 경로와 내용을 요약한 목록이 있었어요. 그런데 Claude Code는 에이전트가 하위 폴더의 파일을 읽거나 고칠 때, 그 폴더의 CLAUDE.md를 자동으로 context에 넣어요. 그래서 목록이 없어도 에이전트는 필요한 순간에 하위 폴더의 CLAUDE.md를 읽게 돼요. (출처: Memory - Claude Code Docs)
예시 프로젝트/
├ CLAUDE.md                     # 최상위 지침 파일. 하위 4곳의 목록이 있었어요
└ app/
  ├ brand/
  │ └ CLAUDE.md                 # 앱 shell·아이콘·로고를 바꾸는 방법
  ├ core/
  │ ├ CLAUDE.md                 # Supabase client, 로그인 확인 layout
  │ └ components/
  │   └ CLAUDE.md               # shadcn UI 컴포넌트 규칙
  └ features/
    └ CLAUDE.md                 # 기능 폴더 구성, DB table·접근 정책 규칙
목록을 지운 뒤에도 에이전트는 하위 폴더의 CLAUDE.md를 읽었어요. CLAUDE.md를 수정한 뒤 에이전트에게 새 DB table을 설계해 달라고 2번 요청했어요. 에이전트는 2번 모두 DB 코드가 있는 하위 폴더의 CLAUDE.md를 가장 먼저 읽고, 그 파일에 적힌 규칙대로 table을 설계했어요.
여러분의 지침 파일에서 no-op을 찾을 때는 Claude Code 공식 문서가 제시하는 기준을 쓰면 돼요. 문서는 줄마다 "이 줄을 지우면 에이전트가 실수할까?"를 묻고, 실수하지 않을 것 같으면 그 줄을 지우라고 권해요. 에이전트가 이미 아는 언어별 표준 관례도 지침 파일에 적지 말라고 안내해요. (출처: Best practices for Claude Code - Claude Code Docs)
다만 에이전트에게 지침 파일을 줄여 달라고만 하면, 에이전트의 동작을 바꾸던(삭제하면 안되는) 문장까지 지워질 수 있어요. AI Hero의 writing-for-agents 소개 글에 따르면, 줄여 달라는 요청을 받은 에이전트는 글을 짧게 만드는 데 집중해요. 글을 읽어서 바로 알 수 있는 것이 길이이기 때문이에요. 하지만 어떤 문장이 no-op인지는 글을 읽기만 해서는 알 수 없어요. 그래서 문장을 지운 뒤에는 같은 작업을 에이전트에게 다시 맡겨, 동작이 그대로인지 직접 확인해야 해요. (출처: The /writing-for-agents Skill - AI Hero)
같은 내용을 여러 곳에 적으면 토큰 사용량이 늘고 내용이 서로 어긋날 수 있어요
둘째는 중복이에요. 같은 내용을 여러 곳에 적은 문장이에요. 예시 프로젝트의 CLAUDE.md에는 test를 어떻게 돌리는지 설명한 문단이 있었는데, test 전용 문서인 docs/agents/testing.md에 같은 내용이 이미 있었어요. 그래서 그 문단을 문서 위치만 알려 주는 한 줄로 바꿨어요.
<!-- 수정 전: CLAUDE.md -->

test는 두 층으로 돌린다. 작업하는 동안에는 바꾼 것을 덮는 test file만 돌리고(`pnpm exec vitest run path/to/thing.test.ts`), 걸러 내지 않은 전체 suite는 CI가 PR마다 돌린다(`.github/workflows/test.yml`). 실행 방법은 `docs/agents/testing.md`에 있다. 화면 상태 code의 구조와 reducer test 방법은 `docs/FRONTEND_STATE.md`에 있다.
<!-- 수정 후: CLAUDE.md -->

test 실행 방법은 `docs/agents/testing.md`에, 화면 상태 code의 구조와 reducer test 방법은 `docs/FRONTEND_STATE.md`에 있다.
수정 전 문단에도 testing.md의 위치를 알려 주는 문장이 이미 있었어요. 위치를 알려 주면서 그 문서의 내용까지 요약해 둔 거예요. 요약을 지워도 에이전트의 답변은 달라지지 않았어요. CLAUDE.md를 수정하기 전과 후에 test를 어떻게 돌리느냐고 에이전트에게 2번씩 물었어요. 4번 모두 에이전트는 testing.md를 가장 먼저 읽고, 고친 파일과 관련된 test만 돌리라고 답했어요.
에이전트의 답변이 같은데도 중복을 지운 이유는 두 가지예요. 하나는 비용이에요. writing-for-agents에 따르면 중복은 토큰 사용량을 늘리고, 내용을 바꿀 때 함께 고쳐야 할 곳을 늘리고, 그 내용을 실제보다 중요해 보이게 만들어요. (출처: writing-for-agents SKILL.md)
다른 하나는 어긋날 위험이에요. 같은 내용을 두 곳에 적어 두면 나중에 한쪽만 고쳐질 수 있어요. Claude Code 문서에 따르면, 두 지시가 서로 어긋날 때 에이전트는 둘 중 하나를 임의로 따를 수 있어요. (출처: Memory - Claude Code Docs)
cache는 원본 파일이 바뀌어도 함께 고쳐지지 않아서 원본과 달라질 수 있어요
셋째는 cache예요. 명령 하나나 파일 하나로 확인할 수 있는 정보를 지침 파일에 다시 적어 둔 문장이에요. cache라는 이름은 writing-for-agents가 붙인 이름이에요. 이런 정보의 원본(single source of truth)은 명령이나 파일 쪽에 있고, 지침 파일의 문장은 그 사본이에요. 예시 프로젝트의 CLAUDE.md에는 검사 명령 pnpm run check가 어떤 검사를 어떤 순서로 실행하는지 나열한 문단이 있었어요. 이 정보의 원본은 package.json의 scripts 항목이에요.
에이전트는 CLAUDE.md에 이 문단이 있을 때도 package.json을 직접 확인했어요. CLAUDE.md를 수정하기 전과 후에 pnpm run check가 무엇을 실행하느냐고 에이전트에게 2번씩 물었어요. 4번 모두 에이전트는 CLAUDE.md의 문단 대신 package.json을 검색해서 답했어요.
수정하기 전에는 에이전트가 한 번, CLAUDE.md의 문단이 package.json과 다르다고 지적했어요.
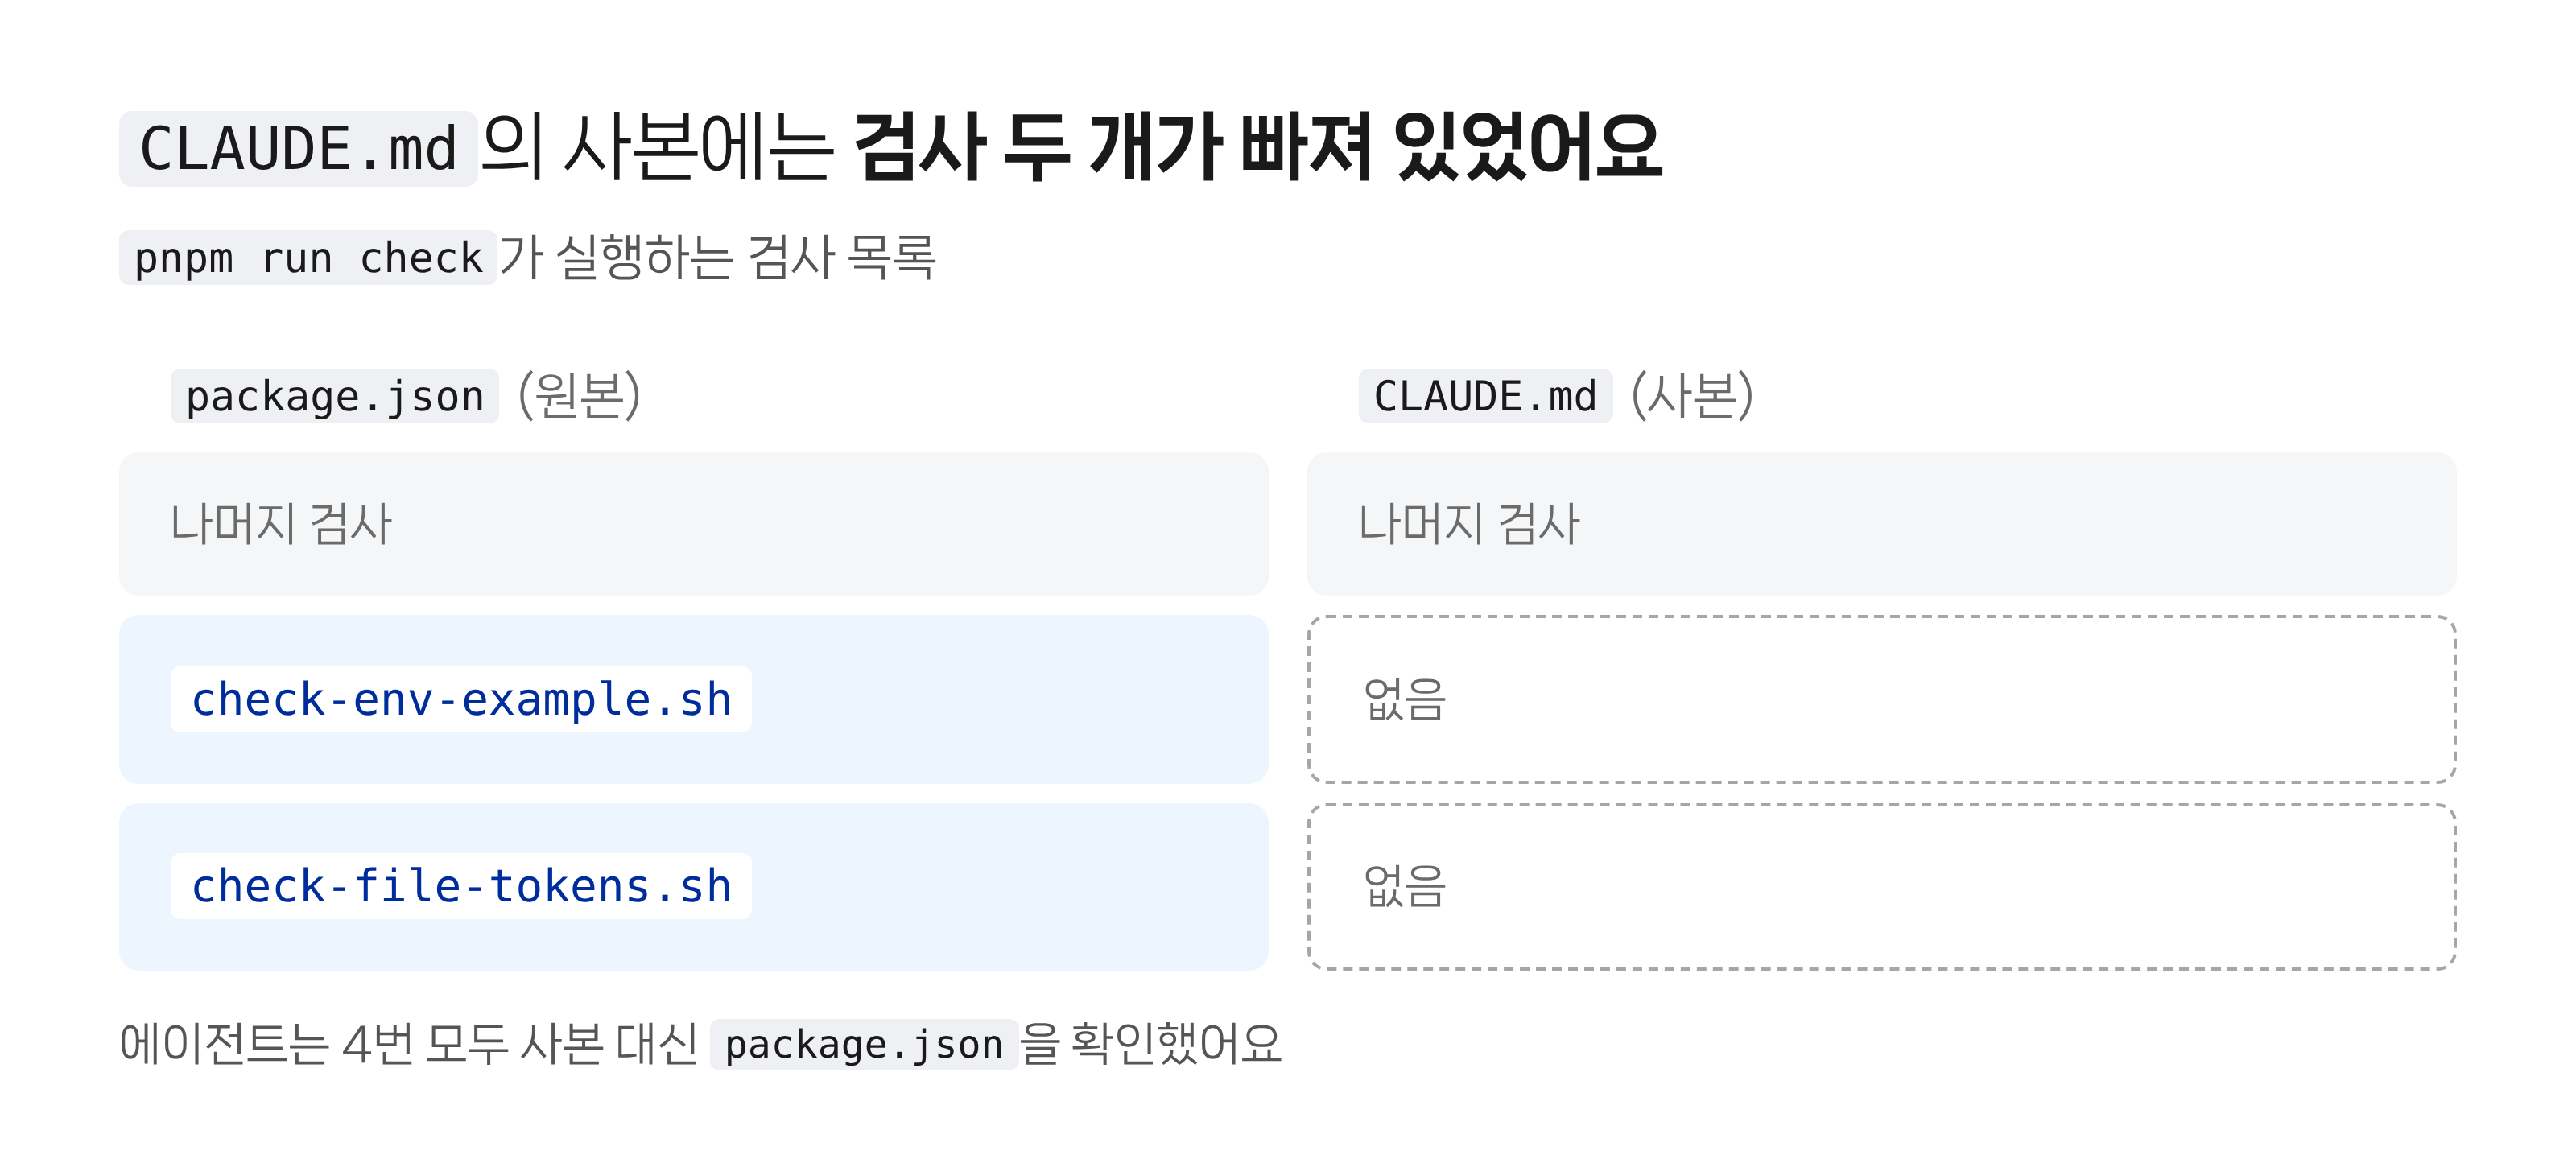
package.json에 따르면 pnpm run check는 check-env-example.sh와 check-file-tokens.sh도 실행하는데, CLAUDE.md의 문단에는 이 두 script의 이름이 없었어요. cache는 원본인 package.json이 바뀌어도 함께 고쳐지지 않아서, 시간이 지나면 sediment가 돼요. (출처: writing-for-agents SKILL.md)
코드와 어긋난 sediment는 에이전트가 틀린 정보부터 확인하게 할 수 있어요
CLAUDE.md를 수정하기 전에는 sediment 때문에 에이전트가 틀린 정보부터 확인했어요.
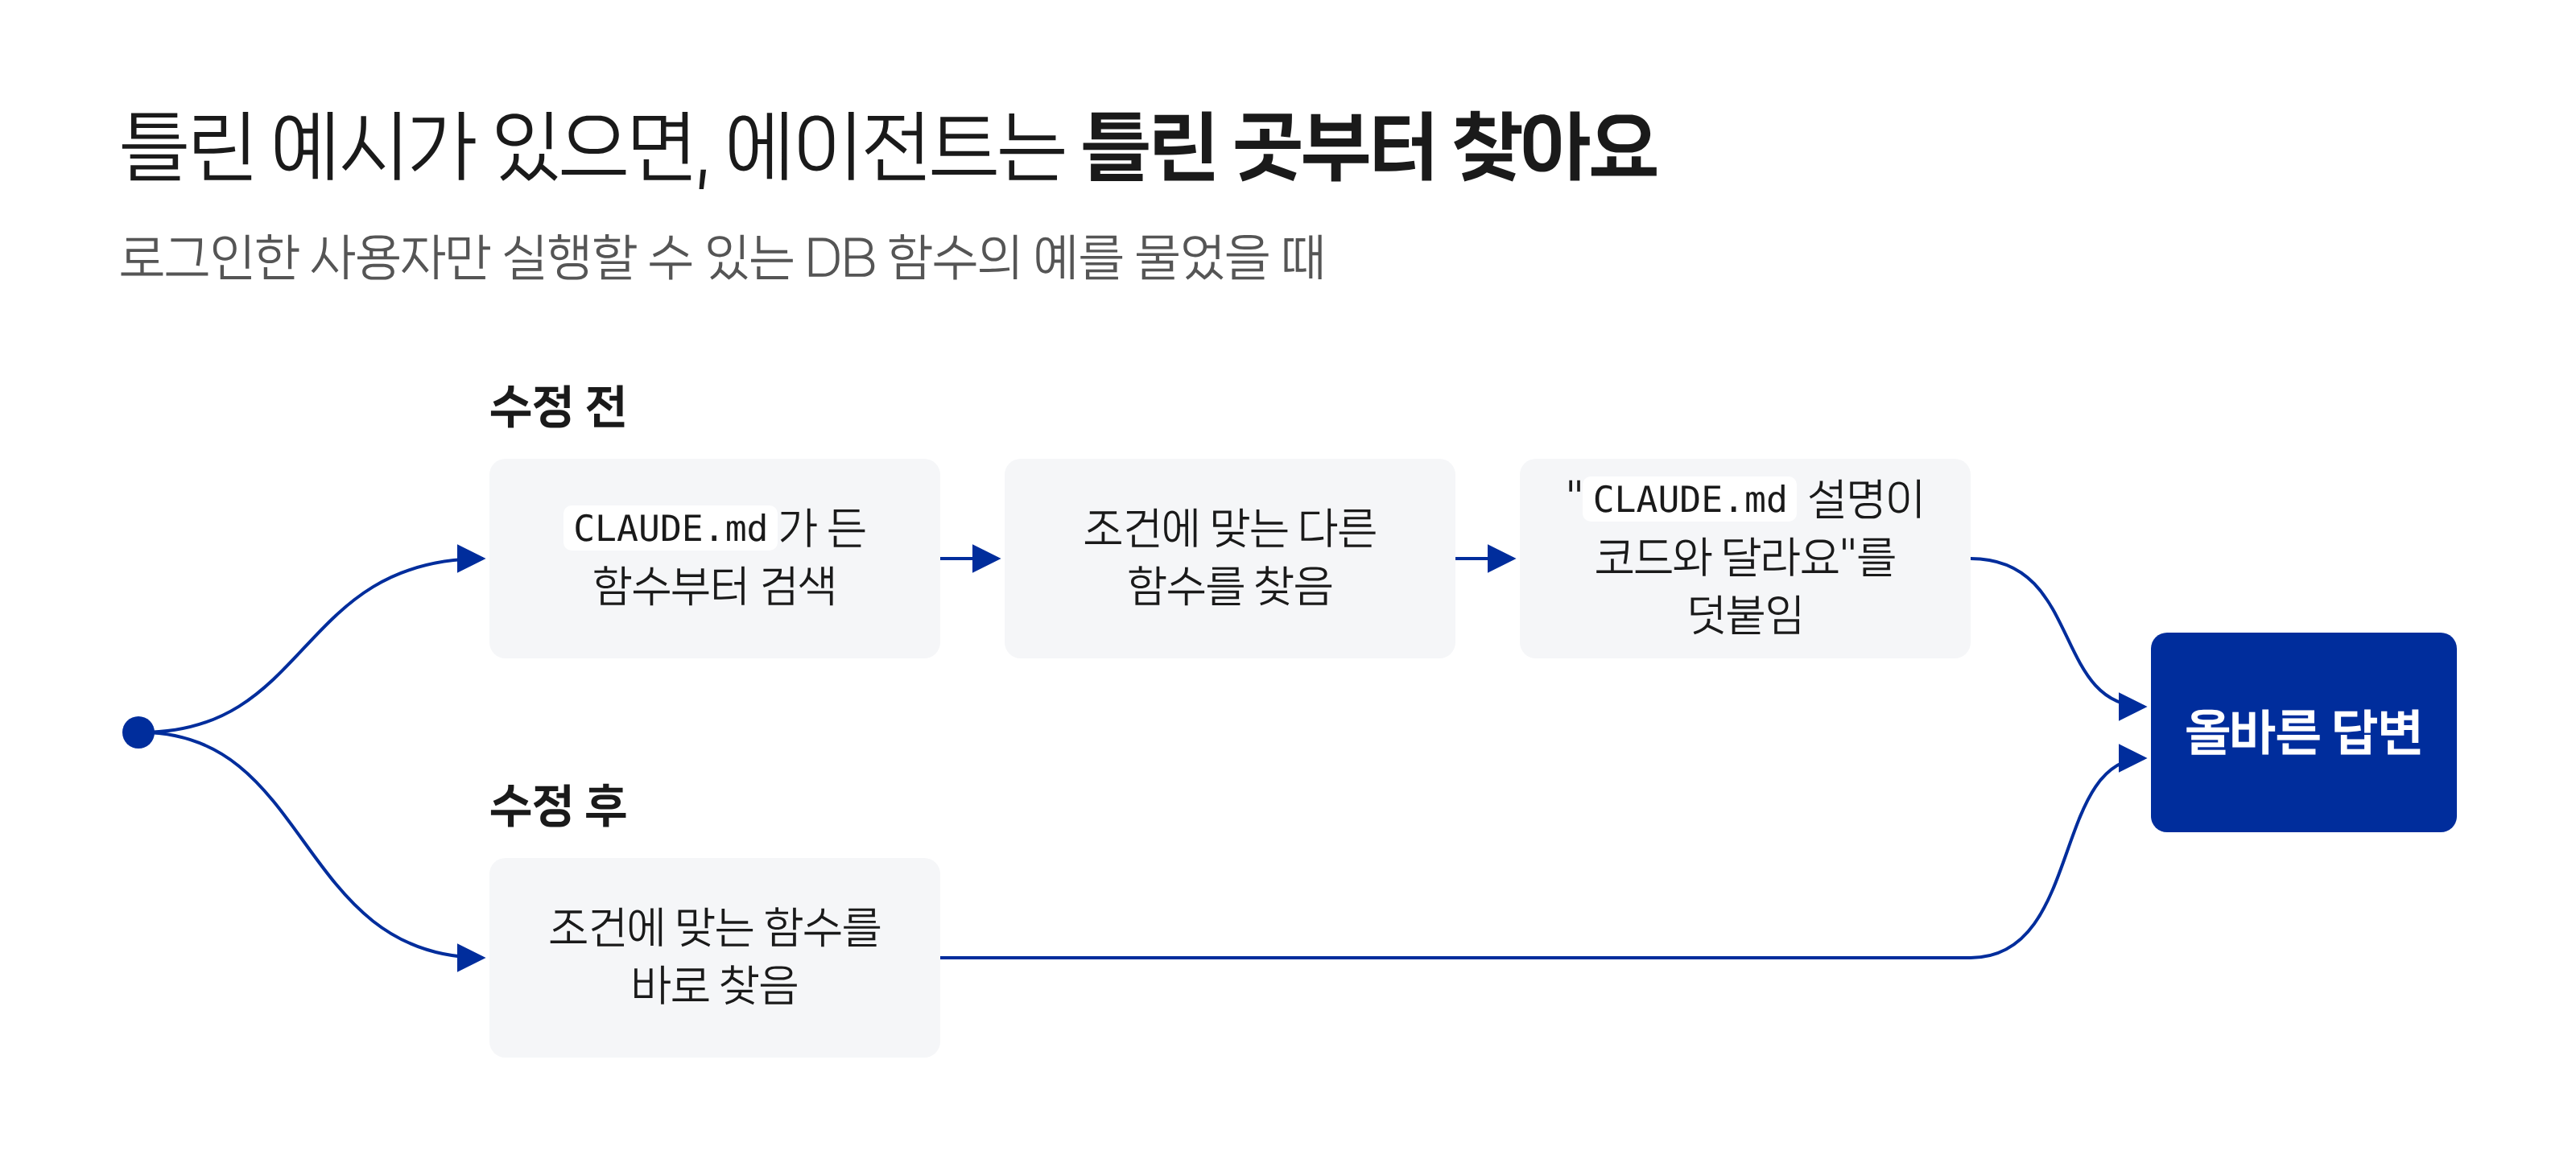
에이전트에게 로그인한 사용자만 실행할 수 있는 DB 함수를 예로 들어 달라고 2번 요청했어요. 에이전트는 2번 모두 CLAUDE.md가 그 예로 적어 둔 함수부터 검색했어요. 앞에서 본 것처럼, 그 함수는 실제로는 로그인하지 않은 방문자도 실행할 수 있는 함수예요. 에이전트는 결국 조건에 맞는 다른 함수를 예로 들었지만, CLAUDE.md의 설명이 코드와 다르다는 설명을 답변에 따로 덧붙였어요. CLAUDE.md를 수정한 뒤에는 에이전트가 처음부터 조건에 맞는 함수를 찾았어요.
코드와 어긋난 문장만 sediment인 것은 아니에요. 옛 모델의 약점을 메우려고 넣은 지시도 새 모델에서는 sediment가 돼요. Claude Code를 만드는 Boris Cherny는 Opus 5가 나온 뒤 Claude Code system prompt의 80%를 지웠다고 말했어요. 그 지시들이 바로잡던 행동을, 새 모델은 지시 없이도 바르게 했기 때문이에요. 그는 Claude Code 사용자에게도 옛 모델 때 필요했던 지시를 지워 보라고 권해요. (출처: Boris Cherny 인터뷰 - YC Root Access)
이런 sediment는 /doctor prompt-audit로 찾을 수 있어요. Claude Code 문서에 따르면 이 명령은 옛 모델을 위해 쓴 지시, 없는 파일이나 명령을 가리키는 문장, 서로 어긋나는 파일을 찾아요. 예시 프로젝트의 CLAUDE.md에 실행하자, /doctor prompt-audit는 CLAUDE.md에 나온 경로 44개와 script 10개가 실제로 있는지 하나씩 확인했어요. 옛 모델에 맞춰 붙인 강조 표시 (CRITICAL)도 지우라고 제안했어요. (출처: Memory - Claude Code Docs)
특정 작업에서만 필요한 내용은 다른 파일로 옮기고 pointer 한 줄만 남겨요
지우지 않고 옮긴 문장도 있어요. 특정 작업에서만 필요한 내용이에요. 이런 내용은 별도 파일로 옮기고, 지침 파일에는 어떤 상황에서 그 파일을 읽어야 하는지와 파일 경로만 한 줄로 남겨요. 이 글에서는 이 한 줄을 pointer라고 부를게요. 에이전트가 필요할 때만 그 파일을 찾아 읽게 하는 방식을 Anthropic은 progressive disclosure라고 불러요. (출처: Effective context engineering for AI agents - Anthropic)
예시 프로젝트는 shadcn CLI로 UI 컴포넌트를 프로젝트에 추가해요. shadcn CLI는 컴포넌트에 딸린 CSS 변수를 공용 CSS 파일(app/app.css)에 써 넣어요. CLAUDE.md에는 원래 이 CSS 변수를 테마 파일(app/theme.css)로 옮기는 절차가 있었어요. 이 절차는 shadcn CLI를 실행한 작업에서만 필요해요. 그래서 shadcn 규칙이 이미 있는 컴포넌트 폴더의 CLAUDE.md로 절차를 옮기고, 최상위 폴더의 CLAUDE.md에는 pointer 한 줄만 남겼어요.
<!-- 수정 전: CLAUDE.md -->

shadcn CLI(`add`, `add --overwrite`)는 받아 온 component의 CSS 변수를 `components.json`이 가리키는 `app/app.css`에 쓴다. CLI를 실행한 뒤 `git diff app/app.css`로 CLI가 쓴 줄을 찾아 다음처럼 정리한다.

- `:root`·`.dark` 안의 값(`--<name>: oklch(...)`)은 `app/theme.css`의 같은 selector block으로 옮긴다. 같은 이름이 이미 `app/theme.css`에 있으면 그 값을 남긴다. 그 값이 복제본의 겉모습이다.
- `--radius-*`·`--shadow-*` 줄은 `app/theme.css`의 `@theme inline`이 맡으므로 `app/app.css`에서 지운다.
- 역할 이름 연결(`@theme inline`의 `--color-<name>`)은 `app/app.css`에 둔다.

Done when `git diff app/app.css` shows no `:root` or `.dark` block and no `--radius-*` or `--shadow-*` line.
<!-- 수정 후: CLAUDE.md -->

shadcn CLI(`add`, `add --overwrite`)를 실행한 뒤에는 `app/core/components/CLAUDE.md` `shadcn CSS Variables`대로 `app/app.css`를 정리한다.
절차를 옮긴 뒤에도 에이전트는 pointer를 따라가 옮긴 절차를 찾았어요. CLAUDE.md를 수정한 뒤에, shadcn CLI로 컴포넌트를 추가하면 app/app.css를 어떻게 정리하느냐고 에이전트에게 2번 물었어요. 에이전트는 2번 모두 pointer에 적힌 shadcn CSS Variables를 가장 먼저 검색했고, 절차에 적힌 규칙 4가지를 빠짐없이 들어 올바르게 답했어요.
pointer를 쓸 때 주의할 점이 있어요.
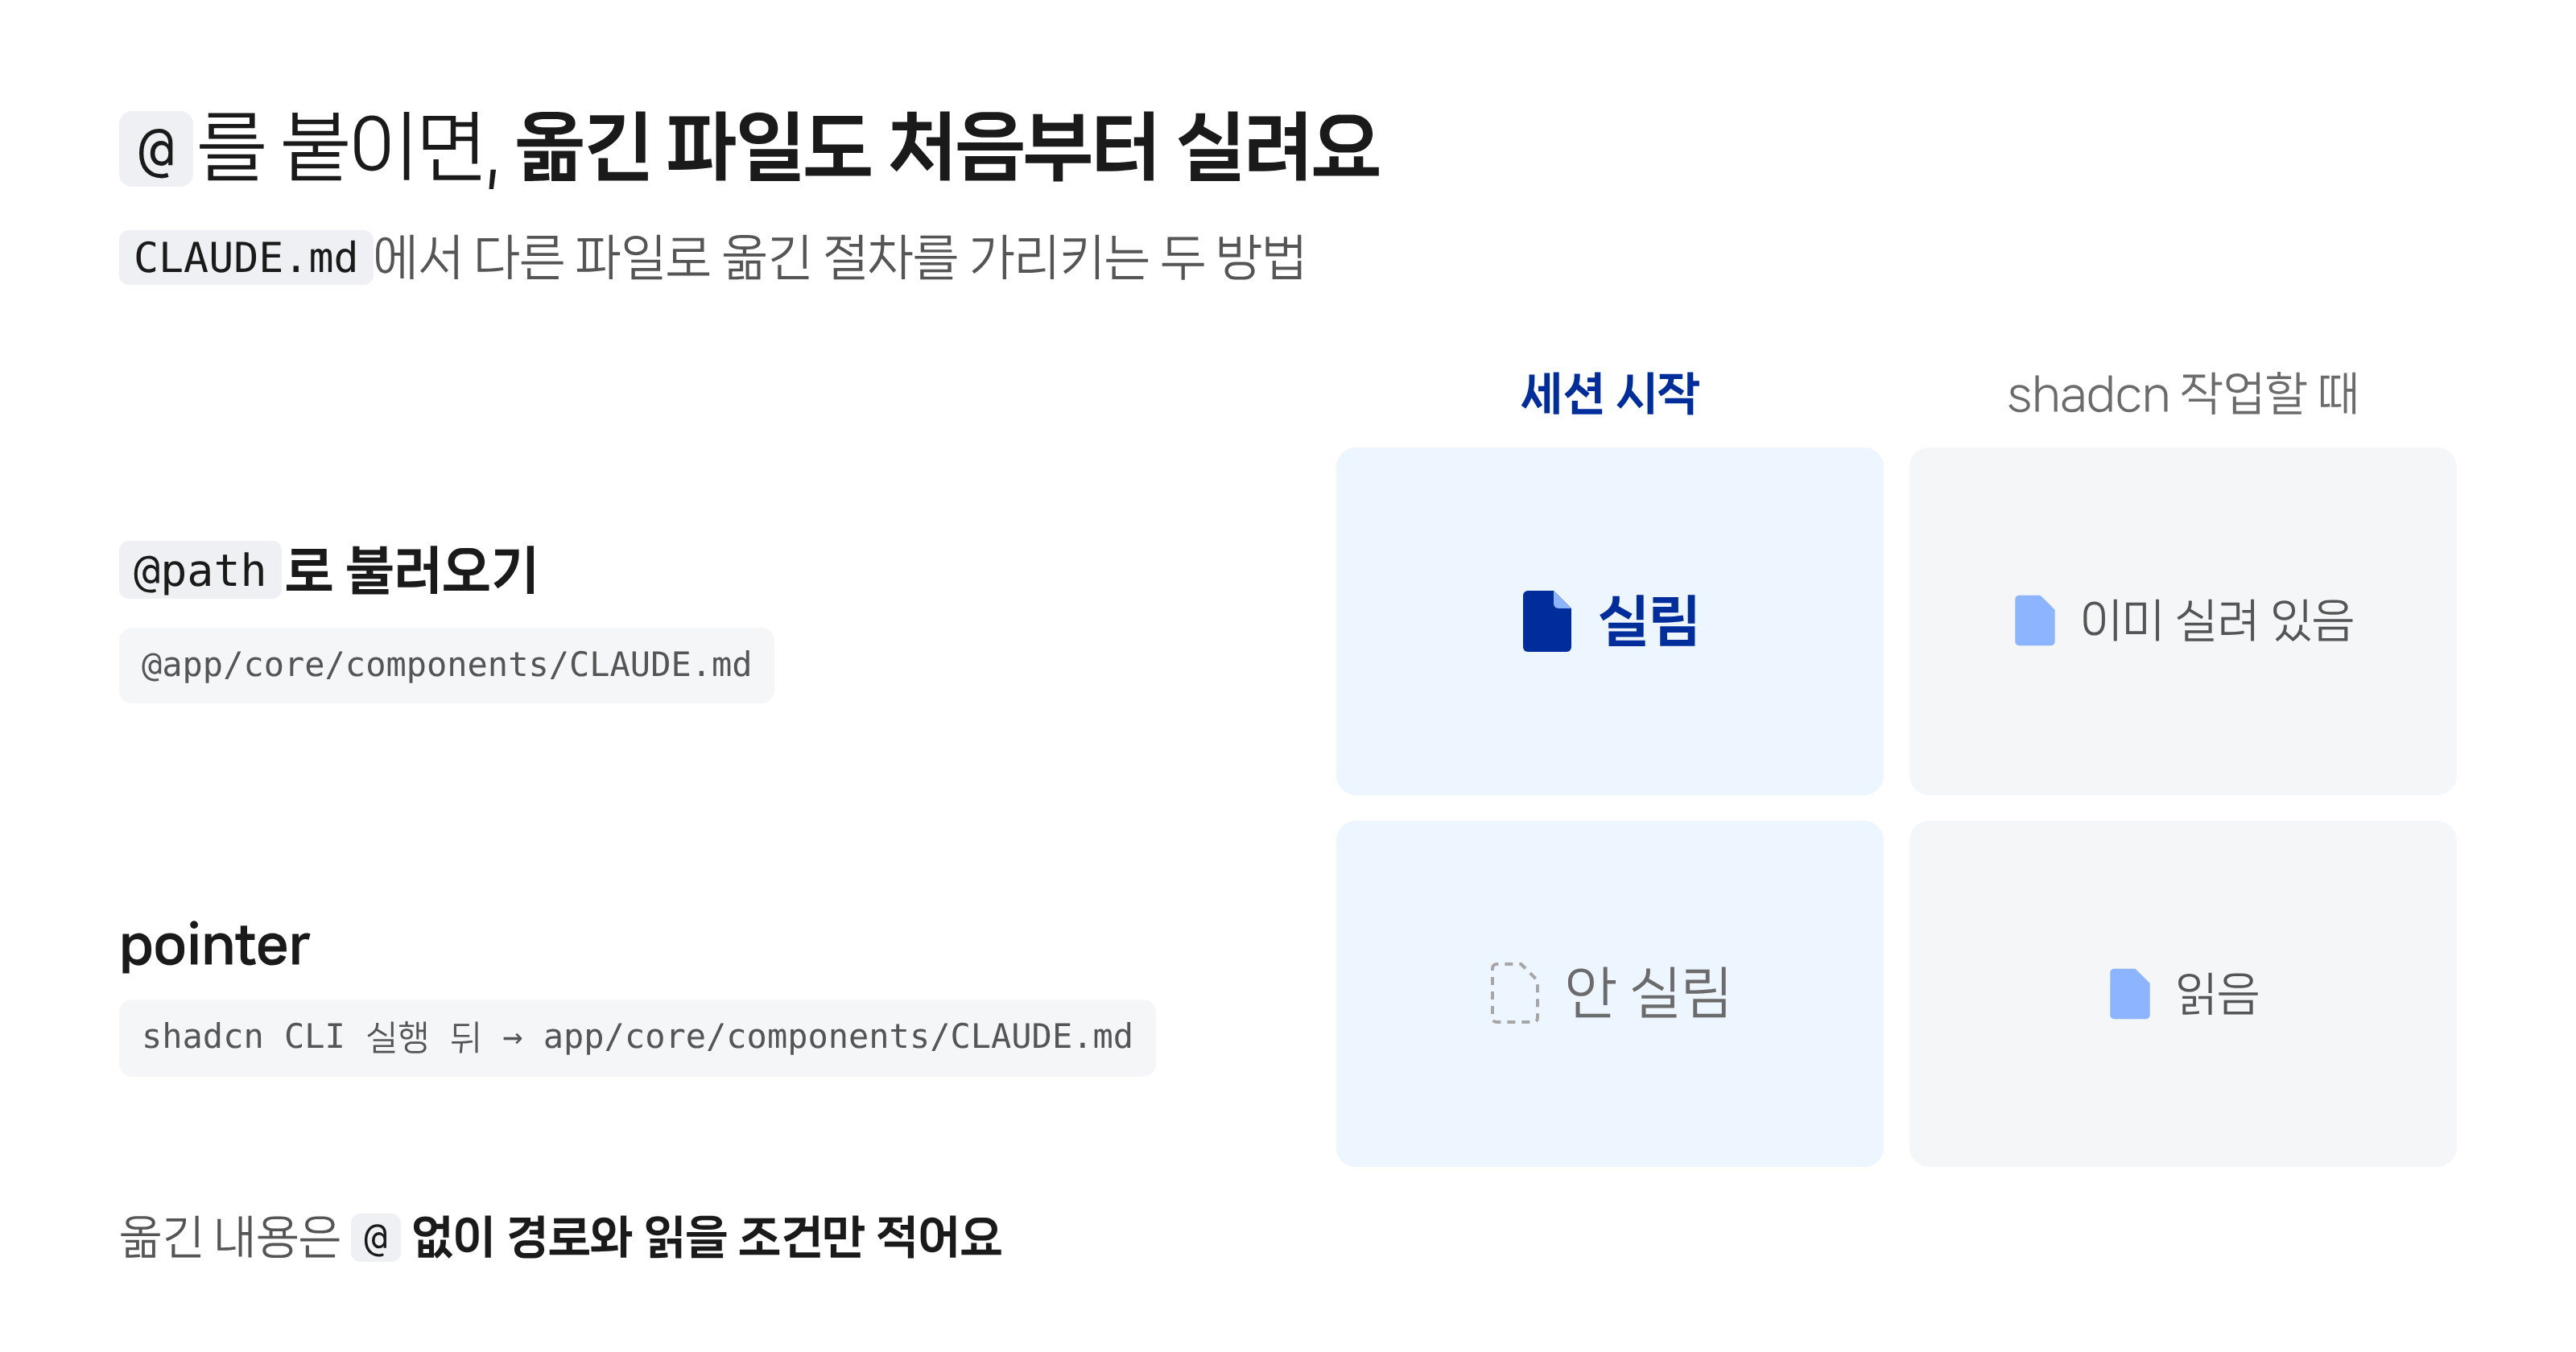
Claude Code의 @path 문법으로 다른 파일을 불러오면, 그 파일도 세션을 시작할 때 함께 context에 들어가요. 그래서 내용을 다른 파일로 옮겨도 @path로 불러오면 토큰 수는 줄지 않아요. pointer에는 @를 붙이지 않고 경로와 읽을 조건만 적어요. (출처: Memory - Claude Code Docs)
Claude Code에는 별도 문서 말고도 skill, path-scoped rule, 하위 폴더의 CLAUDE.md처럼 필요할 때만 context에 들어가는 곳이 있어요. (출처: Memory - Claude Code Docs)
예시 프로젝트의 질문 6개에 에이전트는 CLAUDE.md 수정 전과 후 모두 올바르게 답했어요
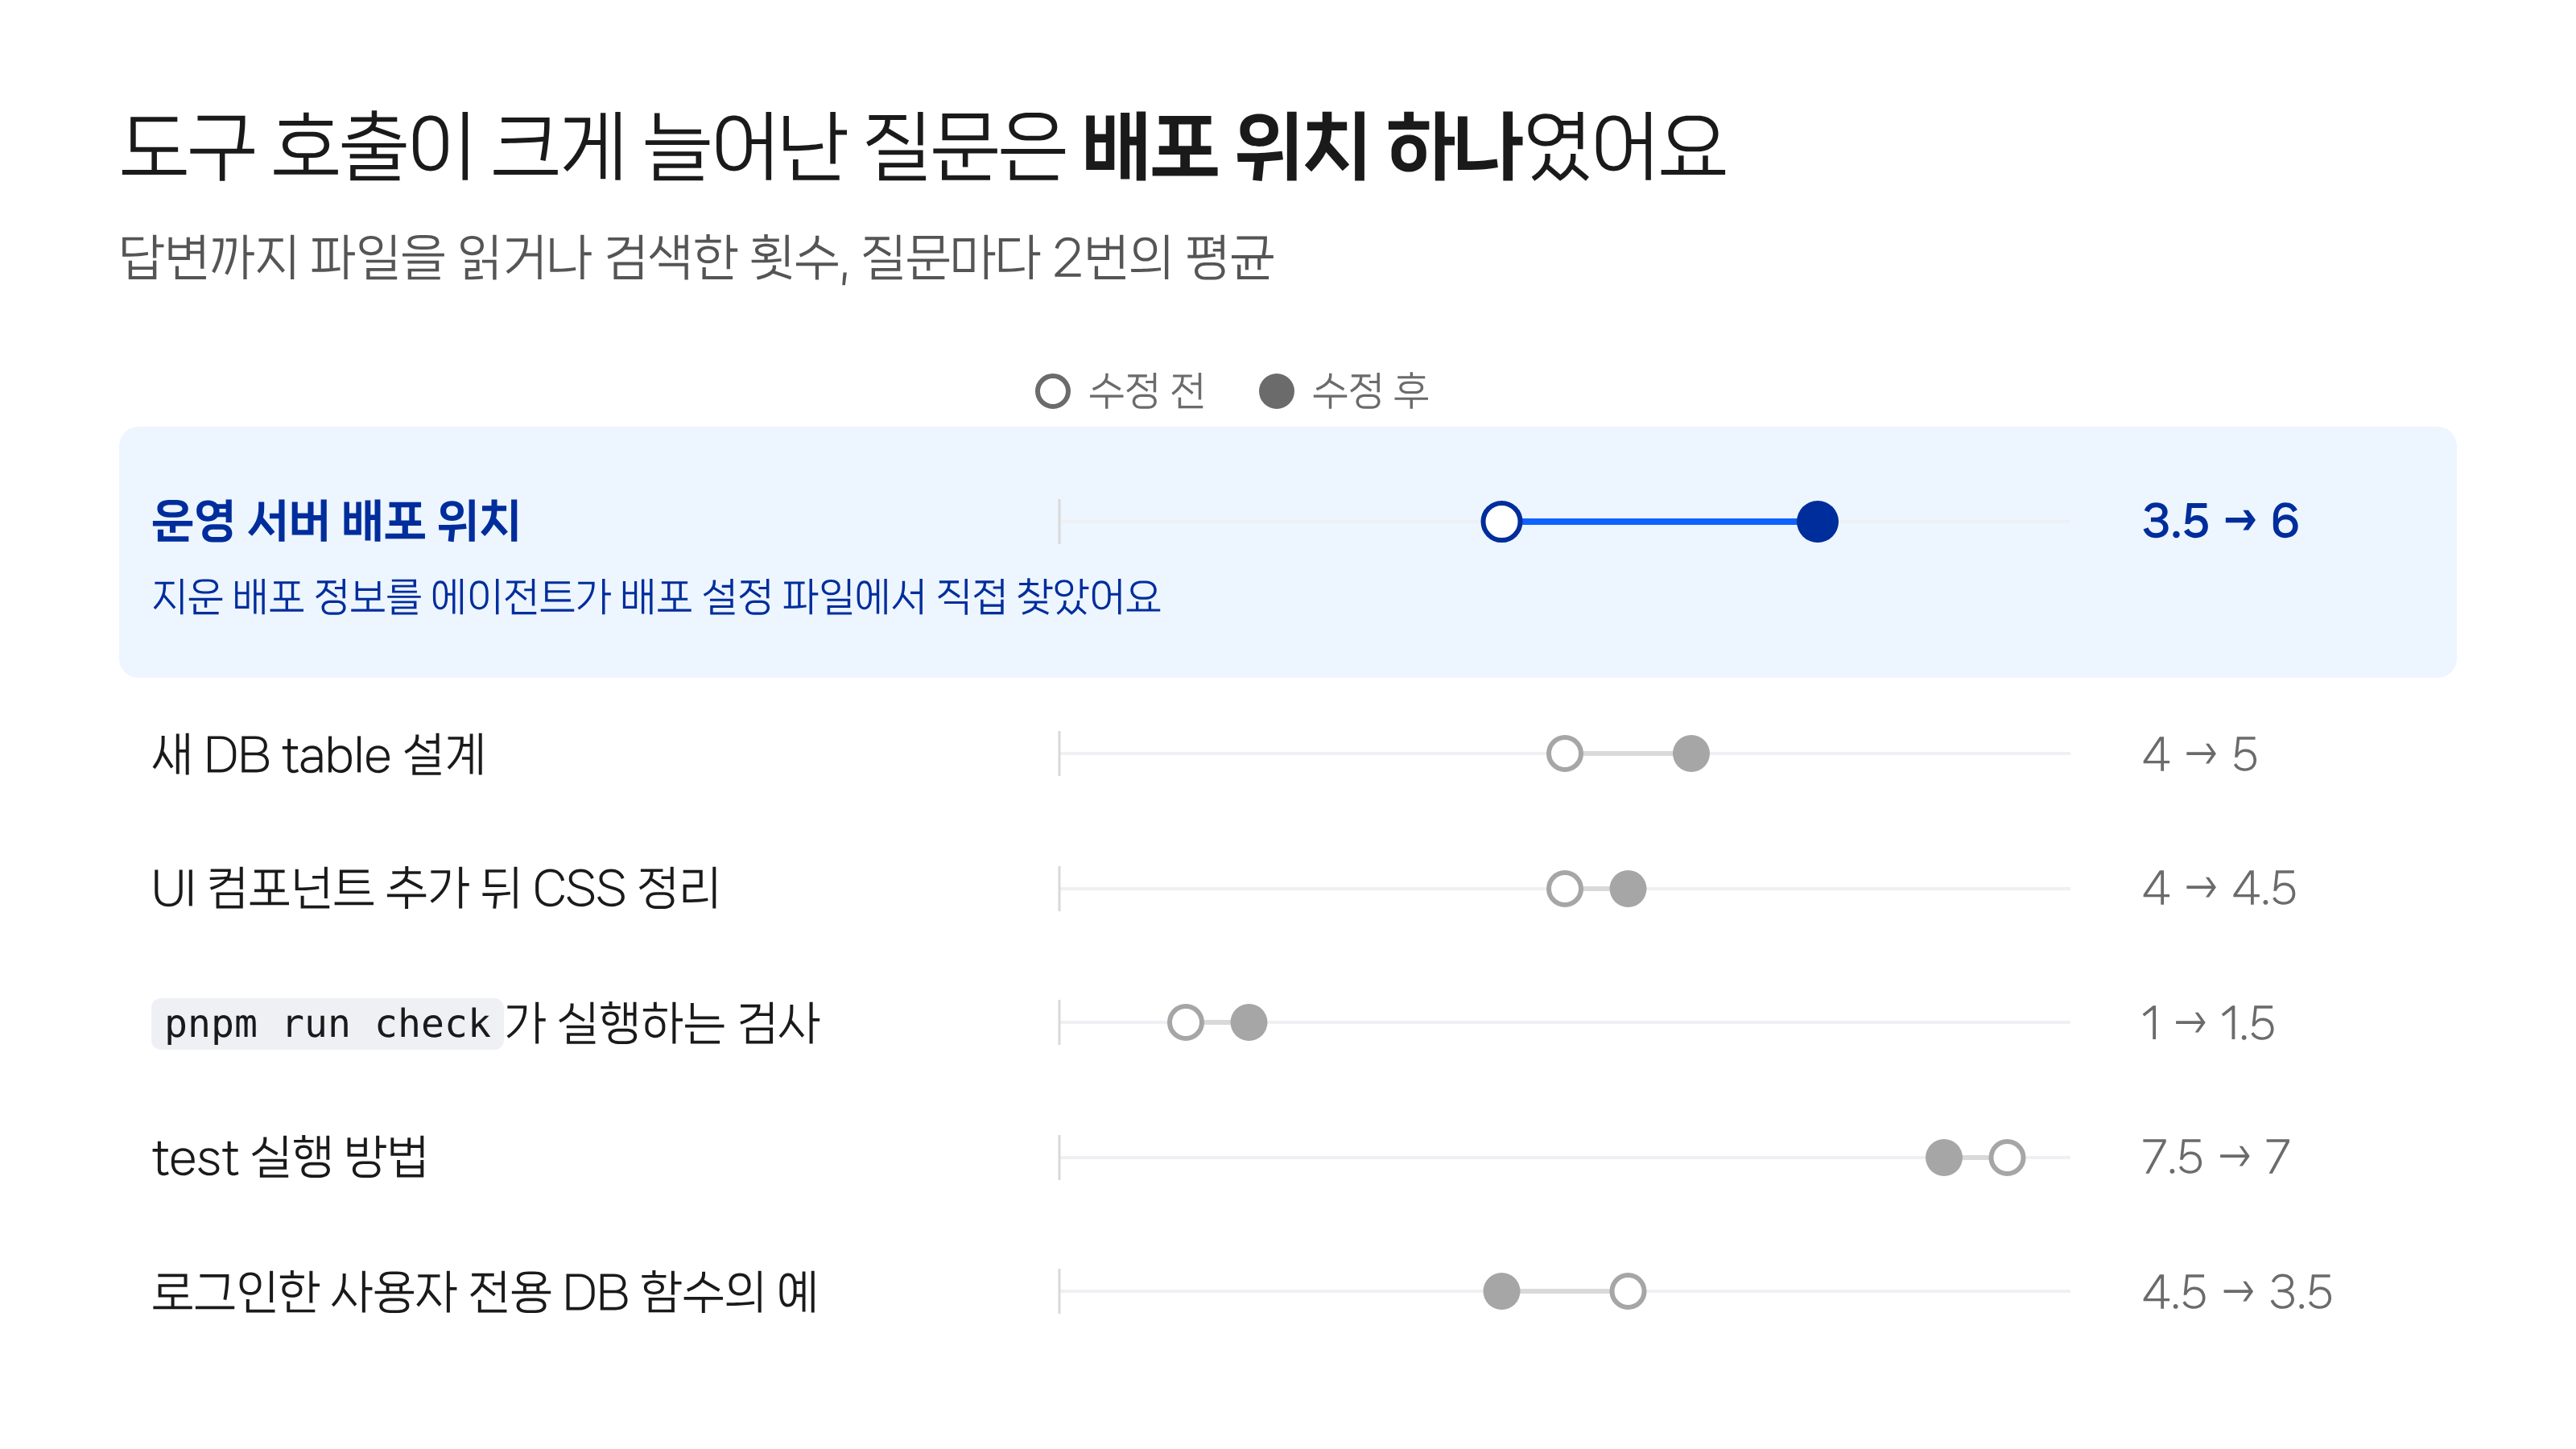
지금까지 소개한 실험 결과를 표 하나로 모았어요. 배포 위치에 대한 질문은 다음 절에서 설명해요. 지우거나 옮기거나 고친 문장마다, 그 문장의 내용을 알아야 답할 수 있는 질문을 하나씩 만들었어요. 질문은 모두 6개예요. 질문마다 올바른 답변에 들어가야 할 내용을 실험 전에 적어 두었어요. 예를 들어 pnpm run check가 실행하는 검사를 묻는 질문이라면, 검사 네 단계를 실행 순서대로 말해야 올바른 답변으로 셌어요. 그리고 CLAUDE.md를 수정하기 전과 후에 각각 에이전트에게 질문마다 2번씩 물었어요.
매번 새 세션을 열었고, 에이전트가 파일을 고치지 못하게 막았어요. Claude Code가 대화 내용을 스스로 기억해 두는 auto memory 기능도 껐어요.
| 질문 | 질문으로 확인한 문장 | 범주 | 올바른 답변(수정 전 / 후) |
|---|---|---|---|
| 새 DB table 설계 | 하위 지침 파일 목록 | no-op | 2/2 / 2/2 |
| UI 컴포넌트 추가 뒤 CSS 정리 | CSS 정리 절차 | 특정 작업에서만 필요한 내용 | 2/2 / 2/2 |
| 로그인한 사용자 전용 DB 함수의 예 | 코드와 다른 함수 예시 | sediment | 2/2 / 2/2 |
| 운영 서버 배포 위치 | 배포 위치 문단 | 저자 판단 | 2/2 / 2/2 |
pnpm run check가 실행하는 검사 |
검사 script 목록 | cache | 2/2 / 2/2 |
| test 실행 방법 | test 실행 설명 | 중복 | 2/2 / 2/2 |
지운 정보를 에이전트가 직접 찾아야 하면 도구 호출이 늘 수 있어요
마지막 사례에서는 /writing-for-agents와 제 판단이 갈렸어요. 예시 프로젝트의 CLAUDE.md에는 운영 서버가 어디에 어떻게 배포되는지 적은 문단이 있었어요. /writing-for-agents는 이 문단을 남기라고 제안했어요. 에이전트가 빌드 설정 파일 하나만 보고 배포 대상을 잘못 짐작하는 일을 막아 준다는 이유였어요. 저는 지웠어요. 예시 프로젝트는 템플릿이라서, 이 템플릿을 복제해 만드는 앱마다 배포 환경이 다를 수 있기 때문이에요. 배포 환경을 한 번 정하면 잘 바꾸지 않는 프로젝트라면 이 문단을 남겨도 돼요.
이 문단을 지운 뒤에도 에이전트는 올바르게 답했지만, 답을 찾기까지 더 많이 검색했어요. 운영 서버가 어디에 배포되느냐고 물었더니, 에이전트는 2번 모두 배포 설정 파일을 찾아 답했어요. 다만 답변하기까지 파일을 읽거나 검색한 횟수, 즉 도구 호출이 평균 3.5회에서 6회로 늘었어요. 질문 6개 가운데 도구 호출이 이만큼 늘어난 질문은 이것 하나예요.
그리고 같은 날 오후, 예시 프로젝트의 배포 대상이 Vercel로 바뀌었어요. 지운 문장 "production은 Vercel이 아니라 EC2의 Docker다"는 반나절 만에 사실과 다른 문장이 됐어요. 남겨 뒀다면 이 문장이 sediment가 됐을 거예요.
도구 호출이 늘면 토큰과 시간도 더 쓰게 되지 않을까요? 질문 6개의 실행 기록을 합쳐 봤어요. 에이전트가 처리한 입력 토큰은 CLAUDE.md 수정 전 12번 합계 116만 토큰, 수정 후 12번 합계 117만 토큰으로 거의 같았어요. 답변까지 걸린 시간도 수정 전 310초, 수정 후 304초로 비슷했어요. 이 질문들은 지우거나 옮기거나 고친 문장을 일부러 묻도록 만든 질문이에요. 에이전트가 다른 파일을 찾아 읽어야 하는 불리한 조건에서도, 토큰과 시간이 거의 늘지 않은 거예요. 그 정보가 필요 없는 세션에서는 CLAUDE.md에서 줄인 1.8k 토큰만큼 덜 실려요.
지침 파일의 줄마다 다섯 가지 질문을 던져 지우거나 옮기거나 고칠 문장을 찾을 수 있어요
예시 프로젝트의 CLAUDE.md에서 no-op, 중복, cache를 지우고, sediment를 고치고, 특정 작업에서만 필요한 내용은 다른 파일로 옮기고 pointer 한 줄을 남겼어요. CLAUDE.md의 토큰 수는 앞에서 본 것처럼 32% 줄었고, 에이전트는 24번 모두 올바르게 답했어요. 도구 호출이 크게 늘어난 질문은 배포 위치 질문 하나였어요. 지운 배포 정보를 에이전트가 직접 찾아야 했기 때문이에요. 다만 이 결과는 프로젝트 하나에서 질문 6개를 수정 전과 후에 2번씩 물어 얻은 거예요.
여러분의 지침 파일을 줄일 때는 줄마다 아래 질문을 던져 보세요.
| 범주 | 던질 질문 | 확인할 곳 |
|---|---|---|
| no-op | 이 줄이 없어도 에이전트가 똑같이 하나요? | 줄을 지운 뒤 같은 작업을 에이전트에게 다시 맡겨 봐요. 흔한 예는 하위 폴더 CLAUDE.md 목록, "코드를 깔끔하게 작성해" 같은 일반 지시예요. |
| 중복 | 같은 내용이 다른 문서에 이미 있나요? 어느 문서 한 곳에만 남길까요? | 핵심 단어로 하위 폴더 CLAUDE.md, docs/, CONTRIBUTING.md를 검색해요. |
| cache | 명령 하나나 파일 하나로 확인할 수 있는 정보를 다시 적었나요? 원본은 어디에 있나요? | package.json의 script, lint·formatter 설정, 디렉터리 구조, --help 출력과 비교해요. |
| sediment | 이 줄의 이름·경로·사실이 지금 코드와 맞나요? 옛 모델을 위해 넣은 지시인가요? | 줄에 나온 파일·함수·명령을 하나씩 찾아봐요. /writing-for-agents와 /doctor prompt-audit의 진단을 한 목록으로 합쳐 고치면 서로 놓친 곳을 메울 수 있어요. |
| 특정 작업에서만 필요한 내용 | 모든 작업에 필요한가요, 특정 작업에서만 필요한가요? | 특정 작업에서만 쓰이면 별도 파일로 옮기고 pointer 한 줄을 남겨요. pointer에는 @를 붙이지 않아요. |
안전 규칙, 이유와 함정, 팀 결정에 묶인 줄은 지우지 않고 남겨요
반대로 지우지 않고 남긴 문장도 있어요. 아래 세 종류는 도구가 지우자고 해도 먼저 따져 보세요.
| 남길 것 | 이유 | 예시 프로젝트의 예 |
|---|---|---|
| 사고를 막는 안전 규칙 | 어느 작업에서든 지켜야 하고, 어겨도 lint나 test가 잡아 주지 않아요. | 비밀번호 같은 인증 정보를 코드에 쓰지 않는 규칙, 에이전트가 운영 DB를 직접 바꾸지 않는다는 규칙 |
| 코드만 보고는 알 수 없는 이유와 함정 | 에이전트가 환경을 뒤져도 찾을 수 없는 정보예요. | DB의 행 단위 접근 정책은 어떤 column을 바꾸는지까지는 막지 못한다는 설명 |
| 기록된 팀 결정에 묶인 줄 | 지우려면 그 결정부터 바꿔야 해요. | lint error 규칙 4개. 팀 결정 기록에 "지침 파일에 적는다"고 정해 두었어요. |
지침 파일을 수정하기 전과 후의 답변을 직접 비교하는 순서는 다섯 단계예요
직접 해 보려면 이 순서를 따르면 돼요.
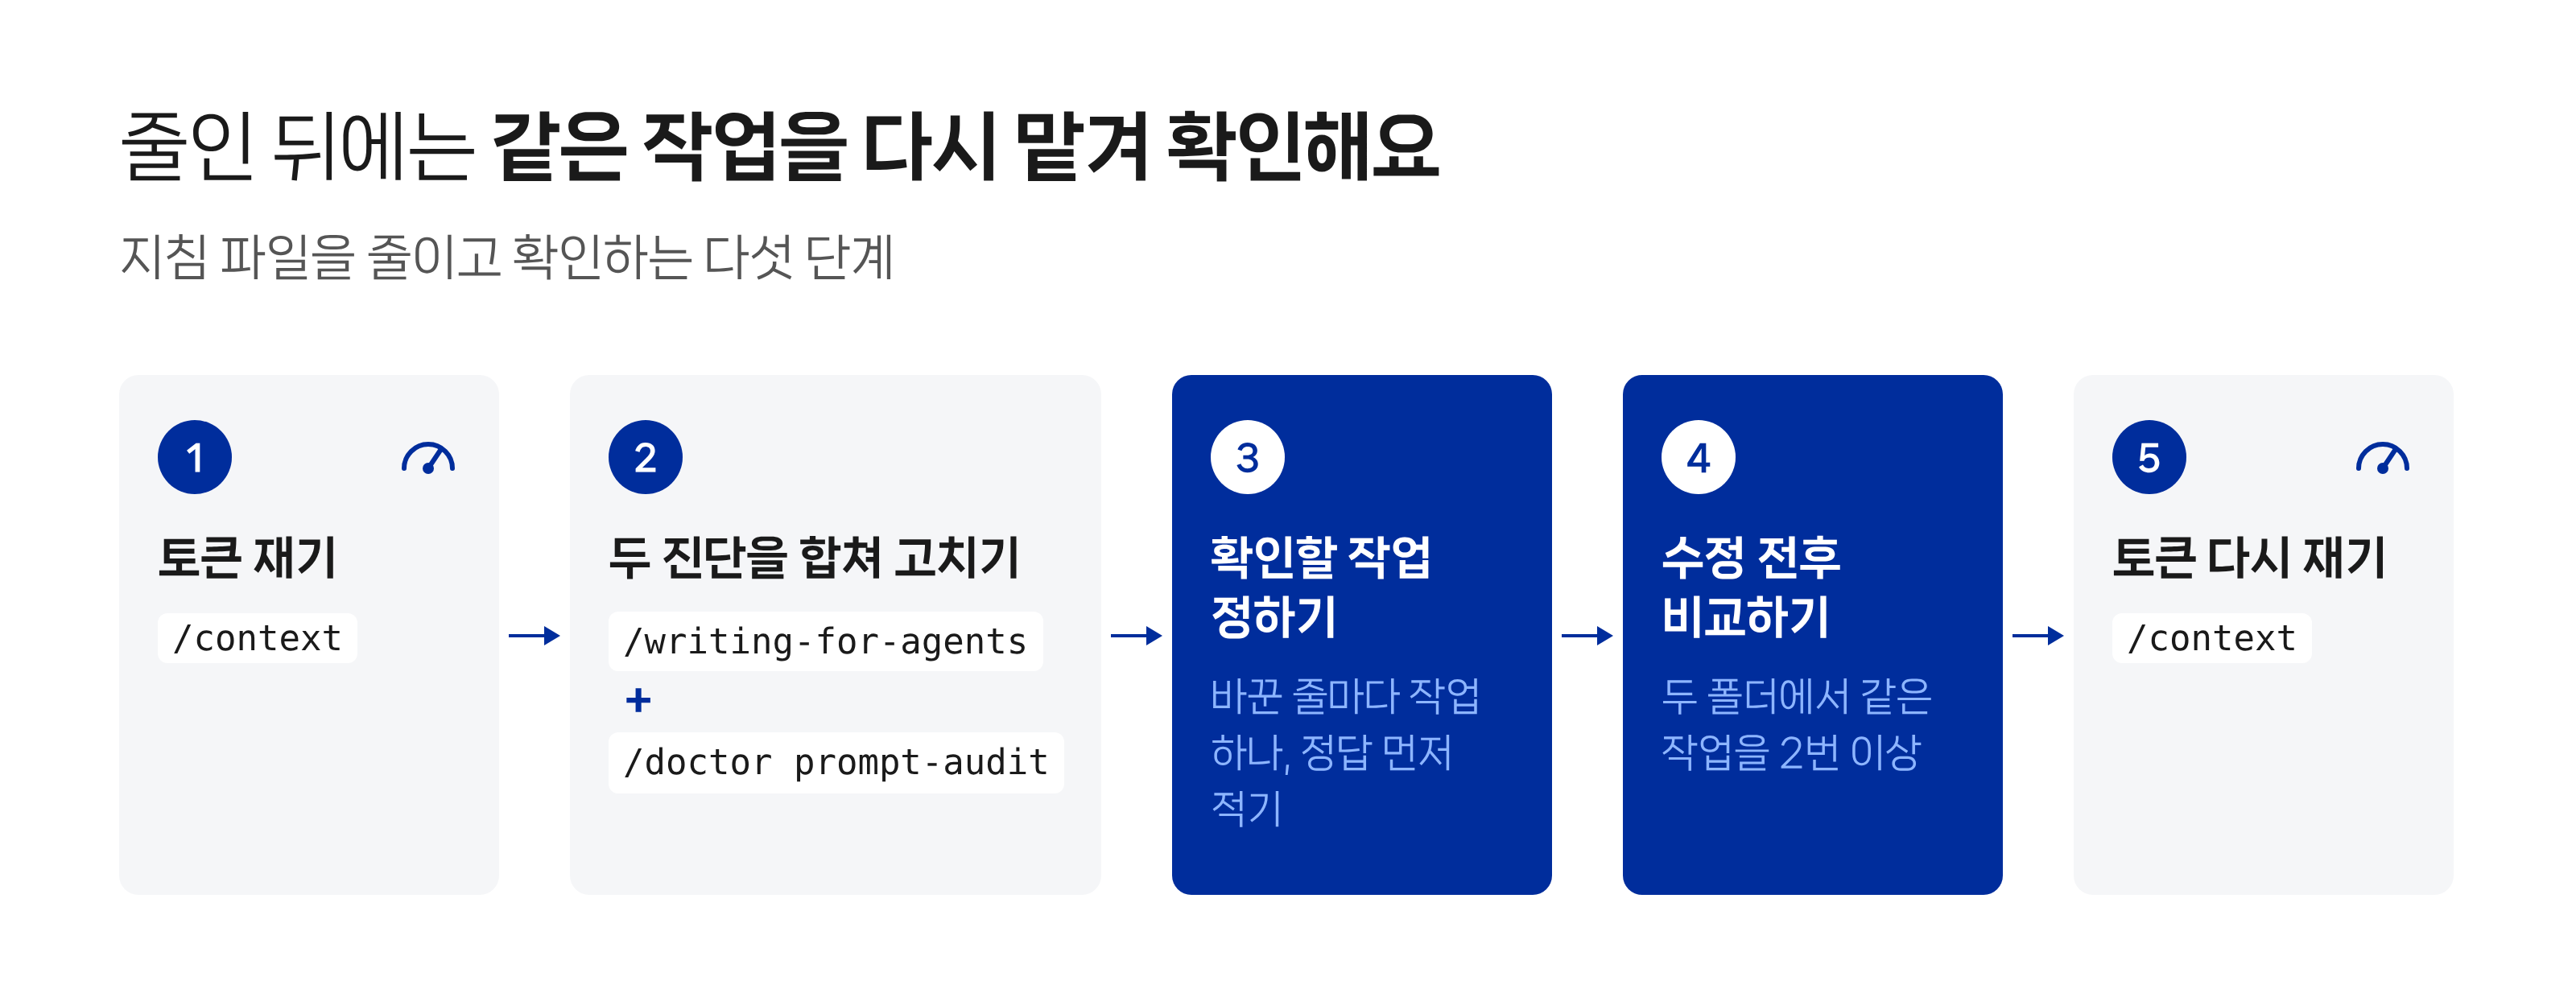
- 새 세션에서
/context를 실행해 Memory files 값과 파일별 토큰 수를 적어 둬요. - 지침 파일에
/writing-for-agents와 Claude Code의/doctor prompt-audit를 모두 실행하고, 두 진단을 한 목록으로 합쳐요. 도구가 사용자에게 판단을 맡긴 줄은 남길 것 세 종류(안전 규칙, 이유와 함정, 팀 결정)에 비추어 직접 판단해요. 그 목록대로 지침 파일을 고치고 커밋해요. - 지우거나 옮기거나 고친 줄마다, 그 줄의 내용을 알아야 제대로 할 수 있는 작업을 하나씩 정하고, 올바른 결과에 들어가야 할 내용을 먼저 적어요.
- 지침 파일을 수정하기 전 커밋과 수정한 뒤 커밋을
git worktree로 각각 다른 폴더에 체크아웃하고, 두 폴더에서 새 세션을 열어 에이전트에게 같은 작업을 2번 이상씩 맡겨요. 그리고 두 폴더의 결과를 비교해요. - 새 세션에서
/context를 다시 실행해 1번에서 적은 값과 비교해요.
/doctor prompt-audit가 실행되지 않을 때/doctor prompt-audit는 Claude Code에 기본으로 들어 있는 skill을 거쳐 실행돼요. 그래서settings.json에서"disableBundledSkills": true로 기본 skill을 꺼 두었다면 실행되지 않아요. 그때는claude --settings '{"disableBundledSkills": false}'로 Claude Code를 열어, 그 세션에서만 기본 skill을 켜요. (출처: Memory - Claude Code Docs)
지침 파일에 문장을 더하고 싶어질 때도 범주별 질문을 그대로 쓸 수 있어요. 그 문장이 no-op인지, 다른 곳에 이미 있는지, 명령 하나로 확인할 수 있는 정보인지 먼저 물어보세요. 더하는 일은 안전해 보이고 지우는 일은 위험해 보여서 sediment가 쌓인다고 했어요.
여러분의 CLAUDE.md는 /context에서 몇 토큰이었고, 줄인 뒤에는 몇 토큰이 됐나요? 줄마다 질문을 던지고 지운 뒤 같은 질문을 에이전트에게 다시 물으면, 에이전트가 여전히 올바르게 답하는지 직접 확인하면서 CLAUDE.md를 줄일 수 있어요.